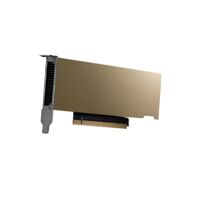
Графический ускоритель NVIDIA L4 24 ГБ GDDR6 PCIe
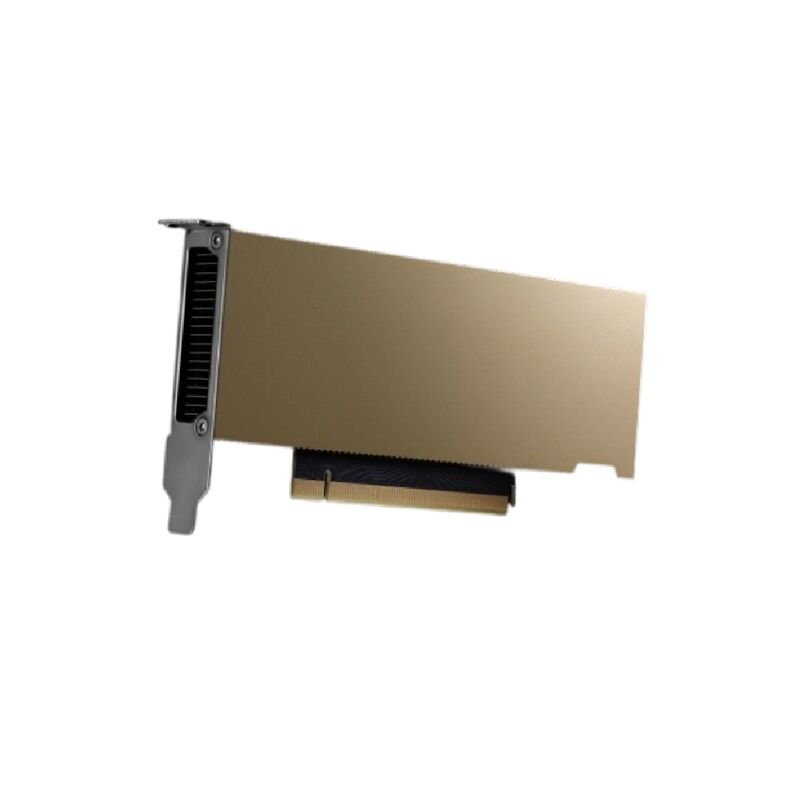
Графический ускоритель NVIDIA L4 — это универсальный GPU на архитектуре Ada Lovelace для серверов, где одновременно нужны видео, ИИ-инференс и графика. Он рассчитан на интеграторов, школьные и университетские ИТ-отделы и команды, которые строят VR/AR-классы, рендер-фермы и ИИ-сервисы без отдельной силовой инфраструктуры. Карта имеет низкопрофильный однослотовый корпус и потребляет до 72 Вт, поэтому подходит для обычных серверов, а не только для специализированных стоек.
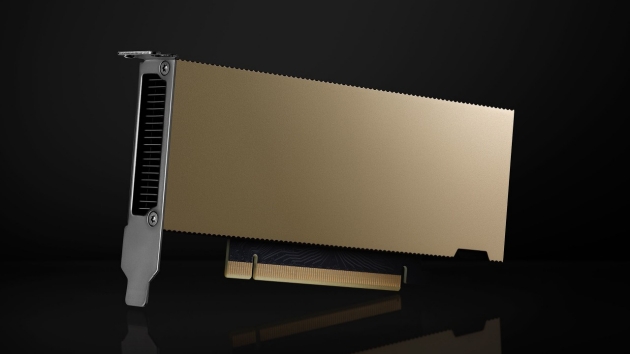
Форм-фактор 1 слот и 72 Вт упрощают установку в сервер
L4 — низкопрофильная карта PCIe Gen4 x16 с максимальным TDP 72 Вт. Такая карта обходится без отдельных мощных блоков питания и громоздкого охлаждения, хотя в ряде серверов дополнительное питание всё же может потребоваться.
Партнёрские и сертифицированные NVIDIA системы допускают от 1 до 8 таких GPU. Для школы или вуза это значит, что можно начать с одной карты и добавлять новые по мере роста числа пользователей. Для сравнения: игровые видеокарты занимают два-три слота и требуют заметно больше питания.
24 ГБ памяти позволяют запускать генеративные модели
Объём памяти 24 ГБ — это запас под нейросети, которые не помещаются в видеокарты поменьше. По данным NVIDIA, на 50% большая ёмкость, чем у предыдущего поколения, позволяет генерировать изображения до 1024x768, а производительность в генеративном ИИ выше до 2,5 раза, чем у T4.
Пропускная способность памяти — 300 ГБ/с. Для инференса и видео это рабочий уровень, но для обучения крупных моделей она будет узким местом.
Видеоускорение: до 1040 потоков AV1 и аппаратные кодеки
В карте два аппаратных кодировщика NVENC, четыре декодера NVDEC и четыре JPEG-декодера. Они берут на себя поток видео, поэтому процессор не перегружается. По данным производителя, сервер с 8 картами L4 обслуживает до 1040 одновременных потоков AV1 в 720p30, а в сквозном ИИ-конвейере с CV-CUDA производительность до 120 раз выше, чем у CPU-решений.
Для образования это трансляции лекций, запись занятий и видеоаналитика. Для VR/AR-классов — потоковая передача картинки на гарнитуры с сервера.
Графика: RT-ядра 3-го поколения и DLSS 3 для виртуальных рабочих станций
Третье поколение RT-ядер и DLSS 3 дают, по данным NVIDIA, более чем 4-кратный прирост в рендеринге в реальном времени и более чем 3-кратный в трассировке лучей. Карта работает с NVIDIA Omniverse, виртуальными рабочими станциями NVIDIA RTX vWS и облачным гейминг-стримингом.
Пример: один сервер с L4 раздаёт 3D-моделирование и CAD-среды студентам на обычные ноутбуки, а тяжёлые вычисления остаются в серверной.
Вычислительная мощность в тензорных ядрах: FP16 до 242 терафлопс
Тензорные ядра 4-го поколения показывают до 242 терафлопс в FP16 и до 485 TOPS в INT8, а FP32 даёт 30,3 терафлопса. Цифры тензорных ядер указаны с разреженностью (sparsity); без неё значения вдвое ниже. Это важная оговорка при сравнении с другими картами.
Ограничения L4: не для обучения больших моделей
L4 — карта для инференса, видео и графики. Для обучения больших нейросетей с нуля лучше взять ускорители с высокоскоростной памятью HBM и межсоединением NVLink. Здесь у карты шина PCIe Gen4 с пропускной способностью 64 ГБ/с, а память скромнее по скорости. Зато экономия на питании и месте в стойке заметна.
Для корпоративных ИИ-задач NVIDIA предлагает пакет NVIDIA AI Enterprise с лицензией, готовыми фреймворками и моделями. Ускоритель работает с более чем 3000 приложений платформы, а также с TensorRT.
| Архитектура графического процессора | NVIDIA Ada Lovelace |
| FP16 | BF16 Tensor Core | 242 TFLOPS |
| FP8 Tensor Core | 485 TFLOPS |
| TF32 Tensor Core | 120 TFLOPS |
| Интерфейсы | межсоединение PCIe Gen4 x16 64 ГБ/с |
| Память графического процессора | 24 ГБ |
| Пропускная способность памяти | 300 ГБ/с |
Это универсальный ускоритель на архитектуре Ada Lovelace (чип AD104, 7424 ядра CUDA, 4-го поколения тензорные ядра, поддержка FP8). Он рассчитан на ИИ-инференс, видеоаналитику и транскодинг, виртуальные рабочие станции и VDI, а также на периферийные (edge) развёртывания. Его главное преимущество — низкое энергопотребление (72 Вт) при компактном размере и 24 ГБ памяти. Для обучения больших моделей он не предназначен.
Хватит ли для языковых моделей (LLM)? | Карта имеет 24 ГБ GDDR6 с ECC, шину 192 бит и пропускную способность около 300 ГБ/с. Объёма хватает для инференса моделей среднего размера (примерно до 7–13B параметров в FP16 или с квантованием, а также для Stable Diffusion и CV-моделей). Узкое место — пропускная способность памяти: в LLM-задачах скорость генерации токенов будет заметно ниже, чем у карт с HBM или GDDR6X с более широкой шиной (A100, H100, L40S, RTX 4090). Для больших моделей нужно несколько карт или более мощный ускоритель.
Карта пассивная, без вентилятора: ей необходим продуваемый корпус сервера с направленным воздушным потоком. Радиатор двунаправленный и принимает поток слева направо и справа налево. Питание берётся только из слота PCIe (максимум 72 Вт), дополнительные кабели не нужны. В обычный настольный корпус без обдува её ставить не рекомендуется — возможен перегрев и троттлинг. Видеовыходов на карте нет, её нельзя использовать как обычную игровую видеокарту для монитора.
Форм-фактор — низкопрофильная (half-height, half-length) однослотовая карта PCIe Gen4 x16 размером примерно 169 × 69 мм. Она подходит для 1U/2U-серверов и компактных edge-систем. Перед покупкой проверьте по списку совместимости производителя сервера (Dell, Lenovo, HPE, Supermicro и др.) наличие свободного слота нужной высоты, поддержку BIOS и достаточный обдув. Если интерфейс слота PCIe Gen3, карта будет работать, но с пониженной пропускной способностью шины.
Да. Для виртуальных рабочих станций и VDI карта поддерживает NVIDIA vGPU (vPC/vApps и RTX Virtual Workstation). Само ПО vGPU требует отдельной лицензии: постоянной с годовой поддержкой либо годовой подписки. Лицензия считается по числу одновременных пользователей. Для обычного ИИ-инференса и вычислений на bare metal лицензия vGPU не нужна. Функция MIG (разделение на аппаратные экземпляры) не поддерживается, а NVLink отсутствует, поэтому объединить память нескольких карт нельзя.
L4 — прямая замена T4: у неё больше памяти (24 ГБ против 16 ГБ), новая архитектура, поддержка FP8 и заметно более высокая производительность при том же низком энергопотреблении. A10 (24 ГБ, до 150 Вт) мощнее, но потребляет больше и занимает полноразмерный слот. L40S (48 ГБ, до 350 Вт) значительно быстрее для генеративного ИИ и обучения, но дороже и требует мощного питания и охлаждения. L4 — оптимальный выбор, когда важны плотность установки, энергоэффективность и бюджет, а не максимальная скорость на одну карту.
По данным зарубежных обзоров, новая карта стоит ориентировочно 2–3 тыс. долларов, а в России цена зависит от поставщика, наличия и курса. Покупайте у официальных дистрибьюторов или интеграторов, уточняйте партномер (например, 900-2G193-0000-000 у NVIDIA или OEM-варианты Dell и Lenovo), срок гарантии и совместимость с вашей моделью сервера. OEM-версии могут быть привязаны к серверам конкретного вендора. Перед оплатой запросите подтверждение поставки и условия технической поддержки.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования