Вычислительная серверная система NVIDIA DGX GB200
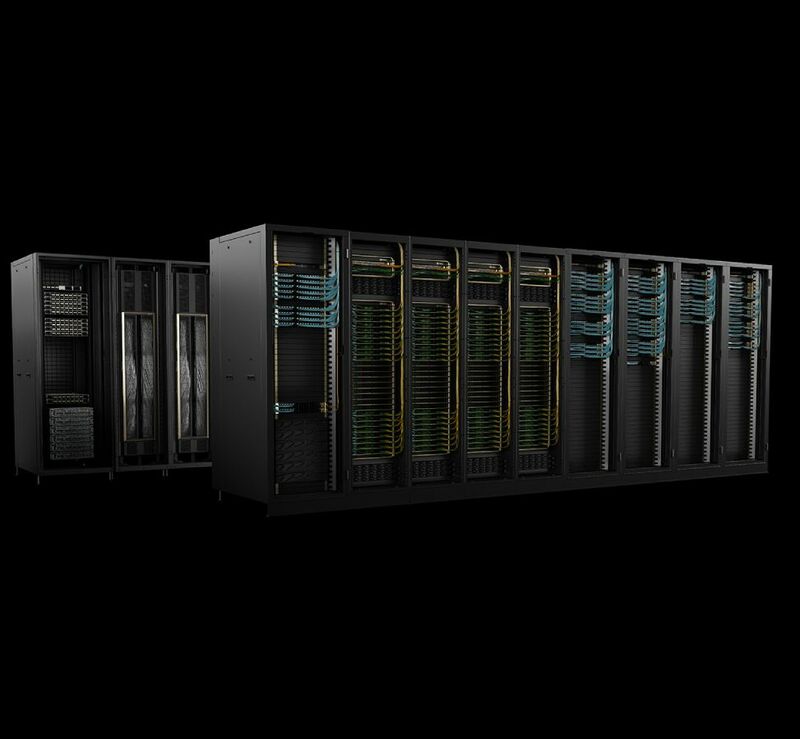
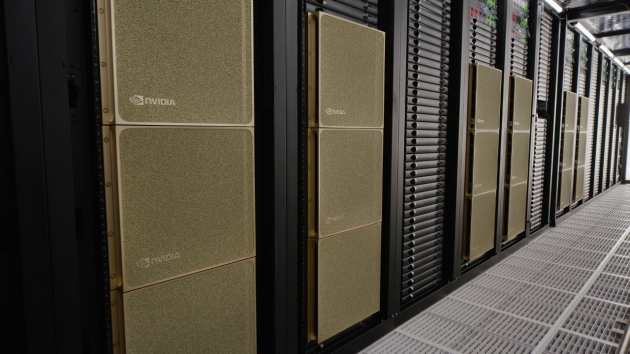
NVIDIA DGX GB200 — стоечная вычислительная серверная система для обучения и инференса крупных генеративных моделей ИИ. Она подойдёт университетам с суперкомпьютерными центрами, исследовательским институтам и дата-центрам, которым нужен готовый «кирпич» ИИ-инфраструктуры вместо самосборного кластера. В одной жидкостно охлаждаемой стойке работают 36 процессоров NVIDIA Grace и 72 графических процессора Blackwell, объединённых в общий домен NVLink. Для NVIDIA это основа задач с моделями на триллионы параметров.
72 GPU работают как один ускоритель
Все 72 GPU стойки связаны пятым поколением NVLink и образуют единый домен, так что для программы они выглядят как один очень крупный ускоритель. Это важно для больших моделей, которые не помещаются в память одного сервера.
В классическом кластере из восьмиGPU-серверов данные между узлами идут по сетевой фабрике, и она становится узким местом. Здесь трафик остаётся внутри стойки, на скоростях NVLink. По данным NVIDIA, суммарная пропускная способность NVLink-домена составляет 130 ТБ/с. Обычный сетевой коммутатор такого не даёт.
Состав стойки: 18 вычислительных узлов и 9 коммутаторов NVLink
Стойка состоит из 18 вычислительных узлов формата 1U и 9 коммутаторов NVLink. В каждом узле стоят два суперчипа GB200, а в каждом суперчипе — один процессор Grace и два GPU Blackwell.
- 2 592 ядра Arm Neoverse V2 на стойку — они берут на себя подготовку данных и управление задачами.
- До 13,4 ТБ памяти HBM3e у GPU с пропускной способностью 576 ТБ/с.
- Всего 30,2 ТБ быстрой памяти — вместе с LPDDR5X процессоров.
- Сеть: 400 Гбит/с InfiniBand через ConnectX-7 и 200 Гбит/с InfiniBand или Ethernet через BlueField-3.
Память здесь важнее пиковых терафлопсов. Если веса модели и контекст помещаются в быструю память, GPU не простаивают в ожидании данных.
Программный стек: DGX OS, Mission Control и AI Enterprise
Система поставляется с программным стеком NVIDIA. В него входят NVIDIA Mission Control для управления и мониторинга, NVIDIA AI Enterprise и DGX OS на базе Ubuntu. Для администратора это значит меньше ручной настройки драйверов и планировщика. Состояние стойки отслеживается централизованно.
В комплекте идёт трёхлетняя стандартная бизнес-поддержка оборудования и ПО.
Сценарии применения в науке и образовании
Первый сценарий — университетский центр ИИ. Здесь на одной стойке обучают собственные языковые модели, а студенты и аспиранты получают доступ к вычислительным ресурсам через планировщик. Второй сценарий — научные расчёты (HPC): моделирование материалов, климата и биомедицинские задачи. Для масштабирования несколько стоек соединяют сетью NVIDIA Quantum InfiniBand. Из восьми стоек NVL72 собирают конфигурацию DGX SuperPOD.
Ограничения: жидкостное охлаждение и требования к ЦОД
DGX GB200 нельзя просто поставить в серверную комнату. Стойка требует жидкостного охлаждения, усиленного электропитания и подготовленного машинного зала. По данным NVIDIA, энергопотребление стойки измеряется десятками киловатт. Поэтому при выборе сначала проверяют готовность площадки: мощность подвода, охлаждающий контур, нагрузку на пол. Только затем сравнивают цену и сроки поставки.
Если задачи сводятся к дообучению небольших моделей и инференсу, воздушно охлаждаемые 8-GPU серверы вроде DGX B200 обойдутся проще. Стойка GB200 окупается там, где нужен единый домен из 72 GPU.
Интегратор Vizzion поможет с подбором конфигурации и поставкой. Актуальные условия и сроки уточняйте у менеджеров на странице товара.
| CPU |
72 графических процессора NVIDIA Blackwell 36 центральных процессоров NVIDIA Grace. |
| Интерфейсы | 72-портовый OSFP-разъем NVIDIA ConnectX®-7 VPI\r\nс поддержкой NVIDIA InfiniBand 400 Гбит/с;\r\n36-портовый NVIDIA BlueField®-3 VPI с поддержкой\r\nNVIDIA InfiniBand 200 Гбит/с и Ethernet. |
| Количество ядер процессора | 2592 ядра Arm® Neoverse V2 |
| Накопитель | 30.2 ТБ |
| Оперативная память | до 13.4 ТБ HBM3e |
| Поддерживаемые операционные системы |
NVIDIA Mission Control NVIDIA AI Enterprise NVIDIA DGX OS Ubuntu |
| Сеть | Контроллер управления материнской платой (BMC) с разъемом RJ45 |
| AI-производительность: | FP4 Tensor Core: 1440 PFLOPS | 720 PFLOPS*\r\nFP8/FP6 Tensor Core: 720 PFLOPS | 360 PFLOPS* |
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования