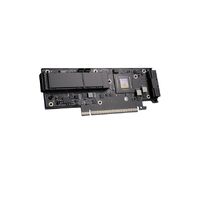
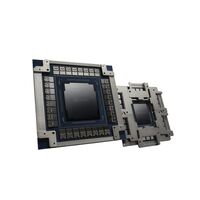
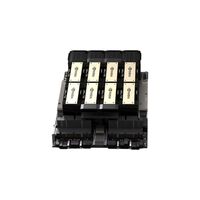
Сетевая платформа NVIDIA Quantum-X800 InfiniBand Platform
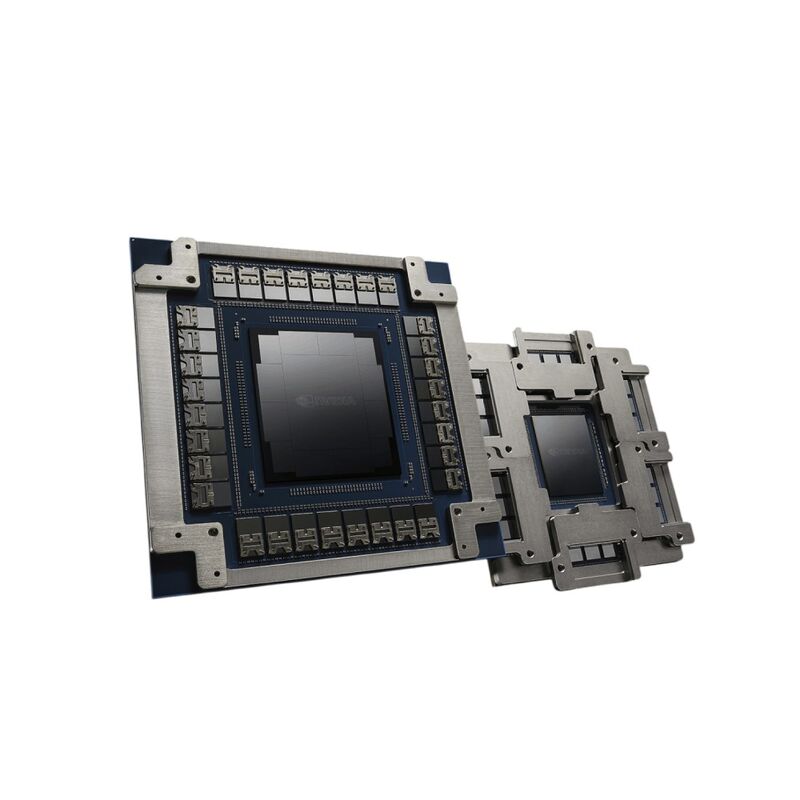
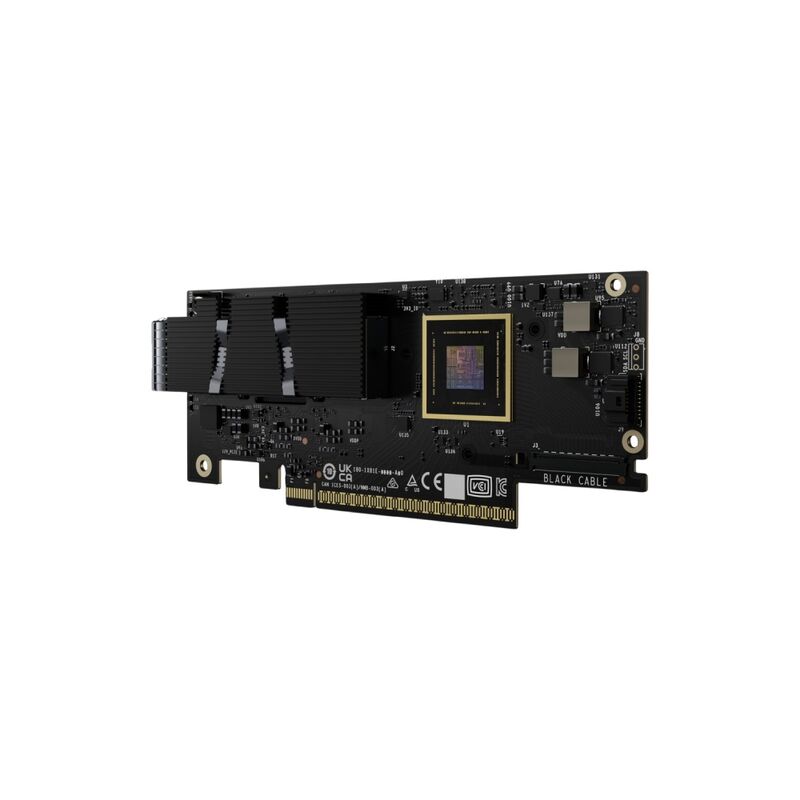
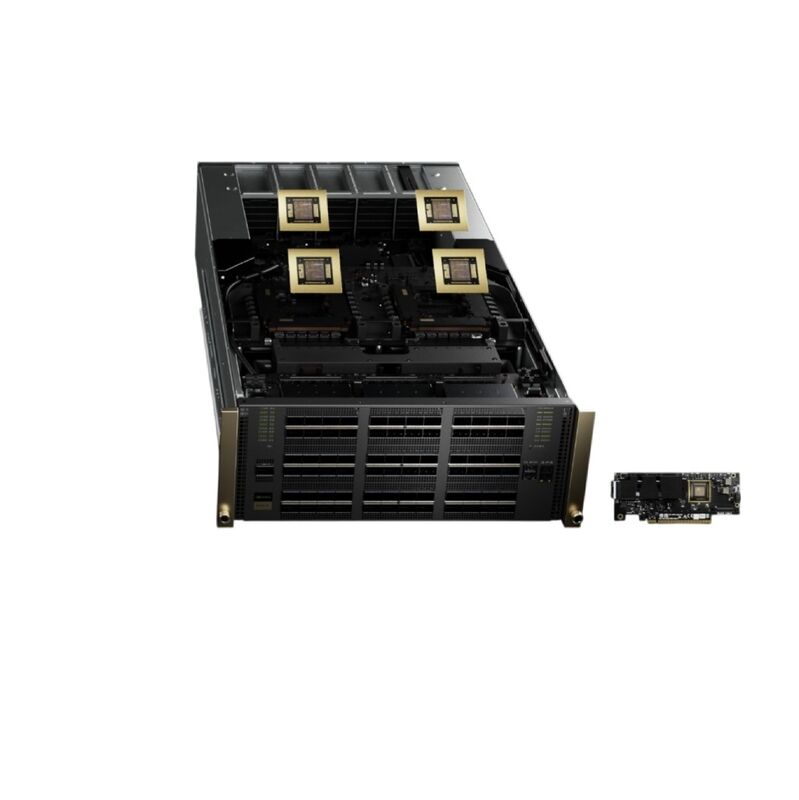
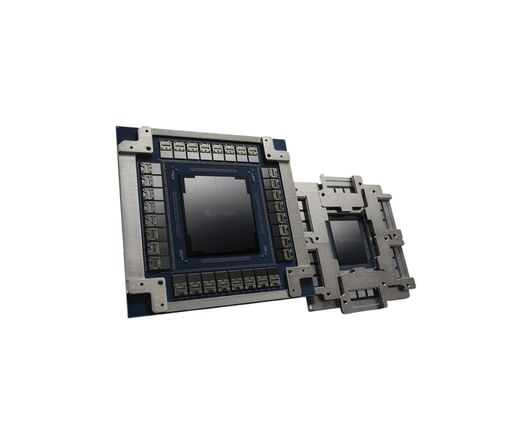
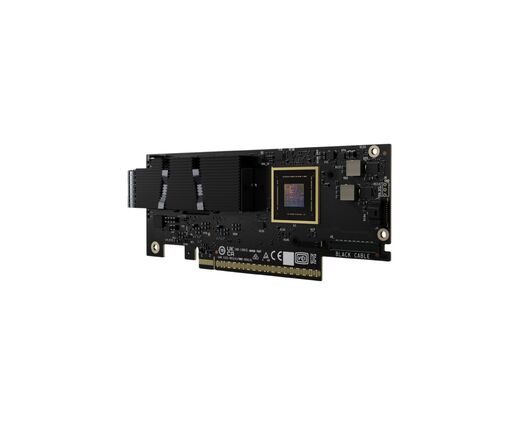
Сетевая платформа NVIDIA Quantum-X800 InfiniBand — сквозное решение на 800 Гбит/с для кластеров, где обучают и запускают крупные модели ИИ. Она нужна тем, кто строит GPU-фабрику и не хочет, чтобы сеть тормозила дорогие ускорители. В состав входят коммутатор Quantum-X800, SuperNIC ConnectX-8 и ConnectX-9, а также кабели и трансиверы LinkX. Производитель позиционирует её как платформу для моделей масштаба триллиона параметров.
Что входит в платформу и зачем это нужно
Платформа состоит из трёх слоёв: коммутатор, сетевые карты и кабельная инфраструктура. Все три рассчитаны на совместную работу, поэтому их проще согласовать между собой, чем собирать сеть из разрозненных компонентов.
- Коммутатор Quantum-X800 даёт 144 порта, каждый на 800 Гбит/с, и выделенный порт для менеджера UFM (Unified Fabric Manager).
- ConnectX-8 и ConnectX-9 SuperNIC обеспечивают до 1,6 Тбит/с на один GPU при низкой задержке.
- Кабели и трансиверы LinkX работают с пассивным оптоволокном и линейными активными медными кабелями (LACC). Это даёт гибкость при выборе топологии.
Вычисления в сети снижают время обучения ИИ-моделей
Технология SHARP v4 выполняет часть операций редукции прямо в коммутаторе, поэтому GPU получают готовый результат и не гоняют лишние данные по фабрике. Это похоже на сортировку почты на узловой станции вместо доставки каждого письма к каждому получателю.
Вместе с SHARP работают адаптивная маршрутизация и управление перегрузками на основе телеметрии. Сеть сама обходит «пробки» и держит предсказуемую скорость, когда множество задач идут одновременно. Функции изоляции производительности не дают одной задаче занять всю полосу и замедлить соседей. По данным производителя, платформа даёт вдвое большую пропускную способность, чем предыдущее поколение, а также рост пропускной способности данных и вычислений в сети.
Энергоэффективность и кремниевая фотоника в крупных кластерах
Энергопотребление сети в большом кластере быстро превращается в заметную статью расходов. В платформе есть режим пониженного энергопотребления канала и профилирование мощности. Версии с кремниевой фотоникой (co-packaged optics) сокращают расстояние между оптикой и электроникой, что снижает потребление и задержку.
Для кого и в каких сценариях
Платформа подойдёт трём группам покупателей:
- Университеты и научные центры, которым нужен суперкомпьютер для моделирования и HPC-задач.
- Корпоративные команды, которые строят собственную «фабрику ИИ» для обучения и дообучения больших моделей.
- Системные интеграторы, которые проектируют кластеры под заказ.
Например, образовательный центр разворачивает GPU-кластер для исследований в области генеративного ИИ. Топологию можно спланировать в онлайн-конфигураторе NVIDIA: он рассчитывает двухуровневое дерево fat tree и Dragonfly+. Для университетских лабораторий с VR/AR и симуляциями такая фабрика даёт основу для обработки больших массивов данных.
Ограничения при выборе для небольших проектов
Это решение не подойдёт для малого кластера из нескольких серверов. Платформа окупается там, где много GPU и сеть действительно становится узким местом. Для небольших нагрузок хватит Ethernet или более ранних поколений InfiniBand: они дешевле и проще в обслуживании. Кроме того, InfiniBand требует специалистов, знакомых с UFM и настройкой фабрики, а выбор между оптикой и медью LACC влияет на дальность и стоимость соединений.
| Архитектура графического процессора | NVIDIA SHARP v4 |
| Пропускная способность памяти | 800 Гбит/с (XDR) на порт |
InfiniBand Quantum-X800 обеспечивает сверхнизкую задержку (менее 100 нс) и отсутствие потерь пакетов. Для обучения ИИ это означает быструю синхронизацию данных между узлами, а для VR/AR/MR — минимальную задержку отклика, что критически важно для предотвращения укачивания пользователей и работы с интерактивным контентом в реальном времени.
Платформа не привязана к конкретному бренду процессоров и отлично работает в гетерогенных средах. Она часто используется в связке с серверами на базе CPU AMD EPYC, Intel Xeon, а также с NPU и CPU NVIDIA Grace, обеспечивая максимальную пропускную способность для любых архитектур.
Платформа предлагает разные форм-факторы, включая компактные 2U коммутаторы на 36 портов. Они отлично подходят для локальных исследовательских и образовательных кластеров, позволяя вузам создавать мощные ИИ-лаборатории без необходимости строить инфраструктуру уровня суперкомпьютерного дата-центра.
Для реализации полной скорости 800 Гбит/с (XDR) потребуются новые трансиверы и кабели с разъемами OSFP. Старые кабели от сетей предыдущего поколения (NDR 400G) не смогут раскрыть потенциал платформы ни физически, ни по пропускной способности, поэтому бюджет на закупку оптики нужно планировать заранее.
Топовые 4U модели требуют подключения к нескольким линиям питания 200-240В (до 8 блоков питания) и мощной системы вентиляции из-за высокого тепловыделения. Если ваша серверная в учебном заведении имеет ограничения по электричеству, рекомендуется выбирать 2U конфигурации с воздушным охлаждением.
Технология SHARP v4 позволяет перенести часть математических вычислений (например, агрегацию данных при обучении моделей) с процессоров серверов (CPU/NPU) прямо на чип коммутатора. Это снижает нагрузку на основные процессоры, освобождая их ресурсы для других образовательных и исследовательских задач.
Да, архитектура платформы поддерживает топологию fat-tree, позволяя без потери производительности объединять в кластер до 10 000 и более узлов. Это дает возможность плавно наращивать мощности по мере расширения парка интерактивного и вычислительного оборудования.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования