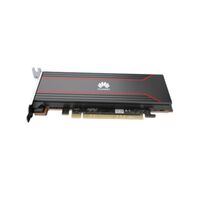
Модуль ускорения ИИ Ascend Atlas 300I Duo
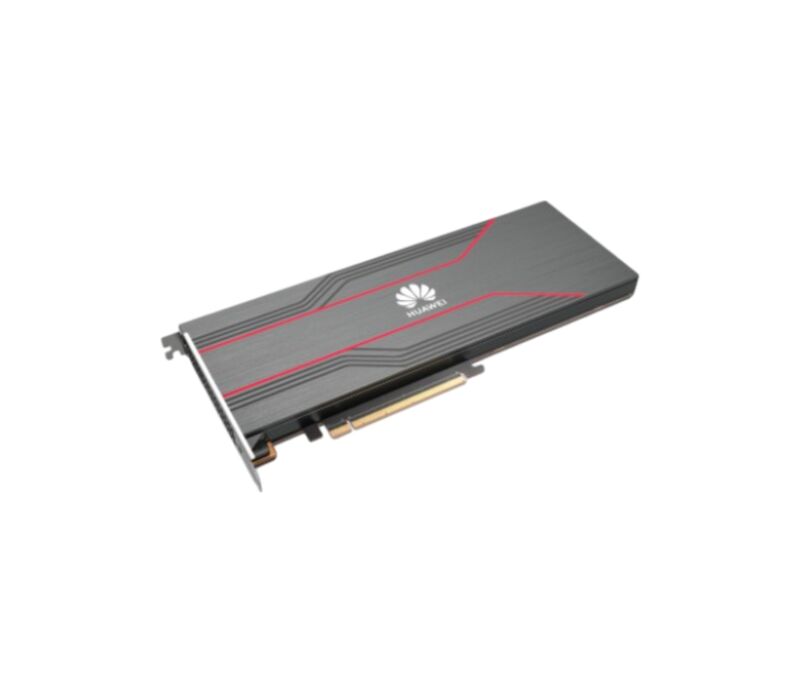
Модуль ускорения ИИ Ascend Atlas 300I Duo — это серверная инференс-карта PCIe для запуска уже обученных нейросетей: языковых моделей, распознавания изображений, видеоаналитики и поиска. Она рассчитана на интеграторов ИИ-инфраструктуры, вузовские лаборатории и команды, которые держат модели на своих серверах. На плате два процессора серии Ascend 310 и до 96 ГБ памяти. Формат однослотовый, а охлаждение пассивное: обдув обеспечивает корпус сервера.
Память до 96 ГБ для локальных языковых моделей
Карта выпускается в версиях с 48 и 96 ГБ памяти LPDDR4X с защитой ECC. Пропускная способность по всей карте — 408 ГБ/с.
У языковой модели веса и кэш контекста занимают много места, поэтому объём памяти здесь важнее пиковых терафлопсов. Большой объём позволяет держать в памяти крупную квантованную модель. Память LPDDR4X медленнее HBM, которую ставят в дорогие ускорители, и это сказывается на скорости генерации. Зато цена за гигабайт заметно ниже. ECC ловит тихие сбои при долгой круглосуточной работе сервиса.
Два процессора Ascend 310 и 280 TOPS в INT8
Пиковая производительность карты — 280 TOPS в INT8 и 140 TFLOPS в FP16. Это теоретические значения, а реальная скорость зависит от модели и программного стека.
В каждом из двух процессоров серии Ascend 310 есть ядра Da Vinci для нейросетей и собственные CPU-ядра. Всего на карте 16 AI-ядер и 16 CPU-ядер с частотой 1,9 ГГц. Часть подготовки данных идёт на самой карте, и основной процессор сервера разгружается. Квантование в INT8 уменьшает модель и ускоряет расчёты, поэтому именно этот формат считают основным для инференса.
Сценарии: чат-бот по документам и видеоаналитика
Первый сценарий — локальный сервис на базе LLM для университета или компании. Он отвечает на вопросы по внутренним документам через RAG, а данные не покидают периметр организации. Для образовательных проектов это удобно: студенты работают с реальным инференс-контуром, а не с облачным демо.
Второй сценарий — распознавание образов, OCR, обработка речи и анализ видеопотоков, где нужны низкое энергопотребление и плотность. Максимальное энергопотребление карты — 150 Вт, вес — 910 г. В один сервер можно поставить несколько карт и наращивать мощность без смены платформы.
Ограничения при работе вне экосистемы Huawei
Карта работает с программным стеком Huawei, а не с CUDA. Это набор CANN, фреймворк MindSpore и адаптеры для PyTorch. Код под NVIDIA придётся адаптировать, а часть оптимизаций появляется с задержкой.
Карта предназначена только для инференса, обучение моделей — не её задача. Вентиляторов на ней нет, так что серверу нужен хороший воздушный поток. Перед покупкой сверьте список совместимых серверов: производитель ориентирует карту на платформы на процессорах Kunpeng. Версию памяти (48 или 96 ГБ) уточняйте у поставщика.
Основные параметры Atlas 300I Duo
Значения взяты из руководства пользователя Huawei и сторонних обзоров. Конкретную комплектацию уточняйте у поставщика.
| Форм-фактор | FHFL, однослотовая, 10,5 дюйма |
|---|---|
| Процессоры | 2 × Ascend 310 (16 ядер Da Vinci, 16 CPU-ядер) |
| Память | LPDDR4X, 48 или 96 ГБ, ECC |
| Пропускная способность памяти | 408 ГБ/с на всю карту |
| Производительность | 280 TOPS INT8, 140 TFLOPS FP16 |
| CPU-часть | 16 ядер × 1,9 ГГц |
| Интерфейс | PCIe Gen4.0 x16, совместим с 3.0/2.0/1.0 |
| Макс. энергопотребление | 150 Вт |
| Охлаждение | Пассивное, обдув от сервера |
| Вес | 910 г |
| Интерфейсы | PCIe Gen 4.0 |
| Форм-фактор | один слот |
| Системная память | LPDDR4X 96 ГБ или 48 ГБ |
| Производительность | 280 TOPS INT8, 140 TFLOPS FP16 |
| Рабочая температура | от 5℃ до 55 ℃ |
| Модель | Ascend Atlas 300I Duo |
| Габаритные размеры (В*Ш*Г) | 266.7 х 111.15 х 18.46 мм |
| Питание | 150 Вт |
Это двухчиповая карта для инференса, не для обучения. На ней две NPU Ascend 310P: по 16 ядер Da Vinci, 280 TOPS INT8 и 140 TFLOPS FP16 суммарно. Память 48 или 96 ГБ LPDDR4X. Типичные задачи: запуск квантованных LLM, модели компьютерного зрения и видеоаналитика. Аппаратный кодек, по данным продавцов, держит до 256 HD-потоков. Обучать большие модели на ней не стоит: стек для этого незрелый, а пропускной способности памяти мало.
Не полностью. 96 ГБ состоят из двух банков по 48 ГБ, по одному на каждый чип Ascend 310P. Система видит карту как два отдельных NPU. Модель, которая не помещается в 48 ГБ, нужно делить между чипами через тензорный параллелизм (TP=2) в vLLM-Ascend или MindIE. Поэтому часть памяти уходит на накладные расходы и обмен между чипами, а полноценной единой памяти, как у одной GPU на 96 ГБ, нет.
Скорость ограничена памятью. Общая пропускная способность 408 ГБ/с, то есть около 204 ГБ/с на чип, а эти показатели не суммируются для одной задачи. Для сравнения, у RTX 3090 около 936–980 ГБ/с. Ранние обзоры сообщают примерно о 15 токенах в секунду на Qwen3 32B. Квантованную модель 70B на карту можно поместить, но скорость будет скромной. Независимых бенчмарков пока мало, поэтому свою модель лучше проверить на тесте.
Это главная проблема. CUDA не поддерживается, используется стек Huawei CANN. Рабочие пути: PyTorch через torch-npu, vLLM-Ascend, MindIE и бэкенд CANN в llama.cpp. Пользователи на форумах жалуются на нестабильность GGUF на CANN, которая зависит от метода квантования, и на слабую совместимость с Ollama и LM Studio. В документации vLLM-Ascend для 300I Duo указаны ограничения. bfloat16 не поддерживается, нужен FP16. Triton недоступен. Параметр max-model-len нужно задавать явно, иначе возможна ошибка нехватки памяти. Граф-режим ограничен.
Карта работает в слоте PCIe 4.0 x16, однослотовая, полной высоты и длины. TDP 150 Вт, по оценкам пользователей реальное потребление ближе к 150–175 Вт. Охлаждение пассивное, поэтому нужен серверный корпус с мощным продувом. В обычный настольный ПК её ставить не рекомендуется из-за нагрева и шума. Также проверьте поддержку в списке совместимости Huawei (Computing Product Compatibility Checker), а в Kunpeng-серверах Huawei поддержка отработана лучше всего. Не все материнские платы x86 корректно определяют карту, поэтому уточните это у поставщика заранее.
Да, есть виртуализация. Каждый процессор серии 310 можно разделить максимум на 7 виртуальных NPU. Виртуальный NPU получает 1, 2 или 4 ядра AI Core, а память и кодеки делятся пропорционально. Это удобно для видеоаналитики и небольших моделей: например, в учебном классе или лаборатории несколько студентов могут работать на отдельных частях карты. Для крупных LLM, которым нужна вся память, такое разделение не подходит. Схему разбиения проверьте по документации вашей версии драйвера.
Официальной розницы в России нет, карты поставляются под заказ. По обзорам и объявлениям, цены на версию 96 ГБ составляют от 1000 долларов на eBay до 1500–1800 долларов на Alibaba и AliExpress. Следует учитывать риски: подержанные или переупакованные карты, отсутствие гарантии и сервиса, а также то, что Huawei находится под санкциями США. Перед покупкой нужно уточнить, какая версия (48 или 96 ГБ), новая ли карта, какая гарантия и какие документы на ввоз, и запросить тестовый запуск вашей модели.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования