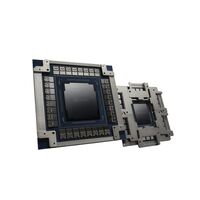
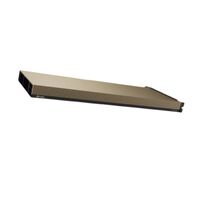
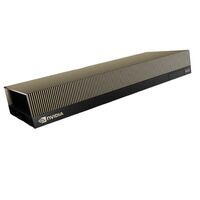
Графический ускоритель NVIDIA H200 NVL (PCIe)
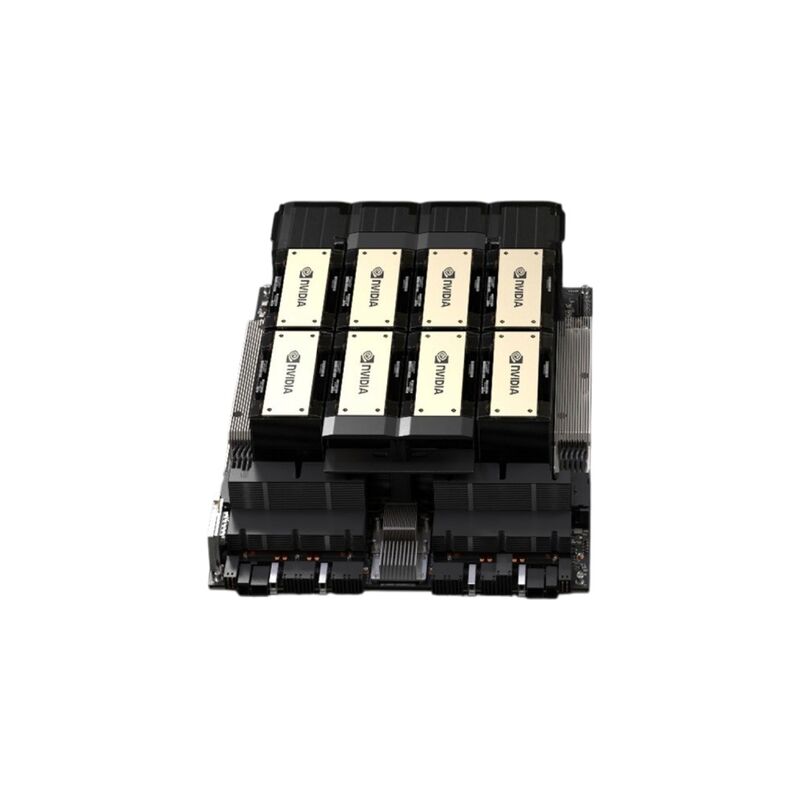
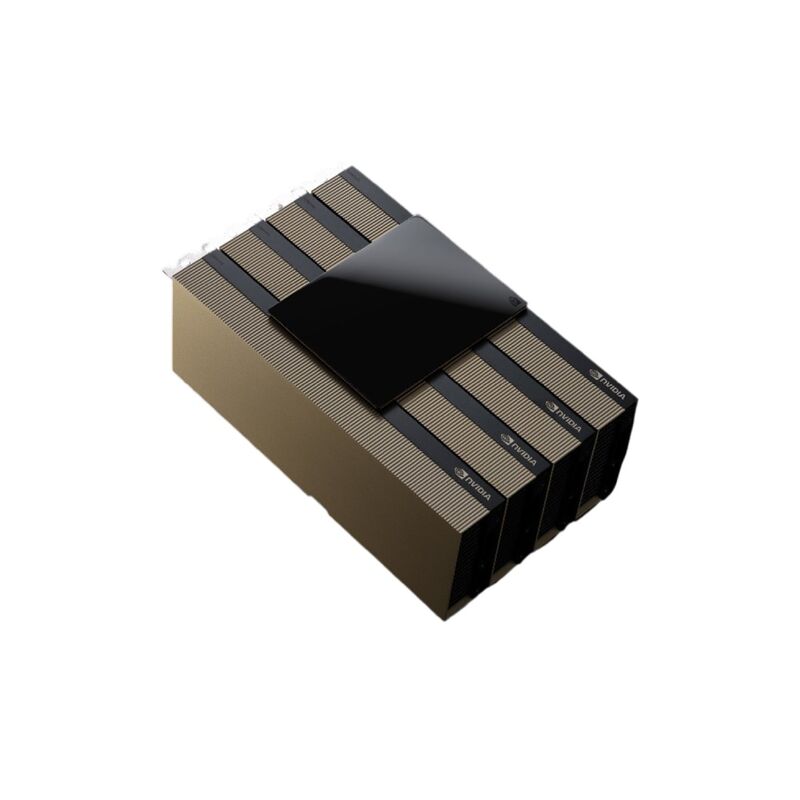
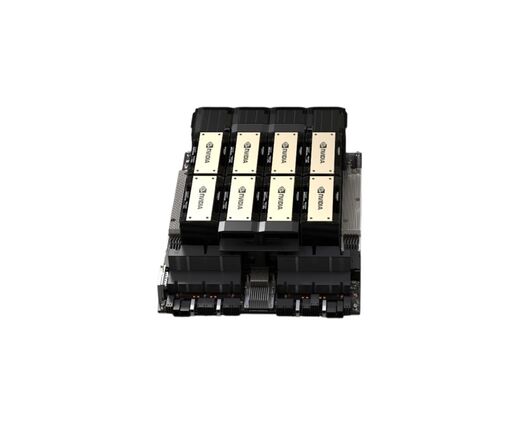
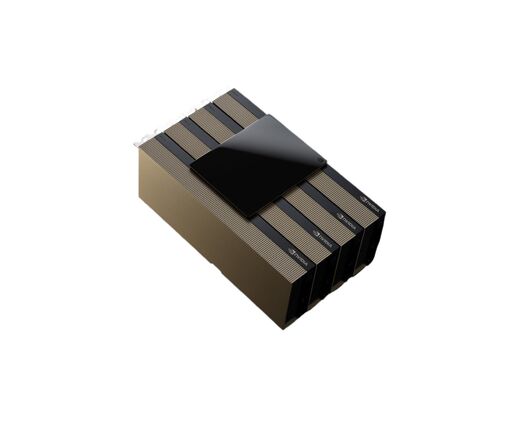
Графический ускоритель NVIDIA H200 NVL (PCIe) рассчитан на корпоративные серверы, где нужно запускать большие языковые модели и вести ресурсоёмкие научные расчёты без перехода на жидкостное охлаждение. Карта построена на архитектуре NVIDIA Hopper и несёт 141 ГБ памяти HBM3e с пропускной способностью 4,8 ТБ/с. Это почти вдвое больше ёмкости, чем у H100, и на 1,4× выше пропускная способность по данным NVIDIA. Для образовательных центров, университетских лабораторий и интеграторов ИИ-решений это способ держать крупную модель на собственном оборудовании.
141 ГБ памяти позволяют держать крупные модели ближе к одному GPU
Объём и скорость памяти — главный довод в пользу H200: большие модели и длинные контексты упираются именно в неё. Чем больше данных помещается рядом с вычислительными блоками, тем реже ускоритель простаивает в ожидании.
NVIDIA заявляет для линейки H200 ускорение инференса Llama2 70B в 1,9 раза и GPT-3 175B в 1,6 раза относительно H100. Для H200 NVL производитель указывает ускорение инференса LLM до 1,7× и прирост в HPC-задачах до 1,3× относительно H100 NVL. Это предварительные данные NVIDIA, полученные на конкретных конфигурациях тестов, поэтому в вашей системе цифры будут зависеть от модели, размера батча и сервера.
Воздушное охлаждение и NVLink: что даёт вариант NVL для стоек
H200 NVL предназначен для маломощных серверных стоек с воздушным охлаждением и гибкой компоновкой. До четырёх GPU можно объединить через NVLink, и тогда они работают как единый пул для задач, не влезающих в одну карту.
Подключение идёт по PCIe, поэтому карту проще встроить в обычный стоечный сервер, чем SXM-модуль, который требует платформы HGX. Для серверов с PCIe-картами у NVIDIA есть архитектура MGX, где заявлена поддержка до 8 GPU.
Сценарии: университетский ИИ-кластер и корпоративный чат-бот
H200 NVL подходит и учебной лаборатории, и бизнесу, которому нужен собственный ИИ-контур. Выбор зависит от того, чем вы заняты: обучением студентов, исследованиями или промышленным инференсом.
- Университет или центр подготовки специалистов разворачивает общий вычислительный ресурс: студенты запускают эксперименты с LLM, компьютерным зрением, симуляциями. Поддержка Multi-Instance GPU позволяет делить одну карту на несколько изолированных частей, так что группы не мешают друг другу.
- Компания или интегратор строит внутренний ассистент с RAG на собственных документах. Данные остаются в периметре, а режим конфиденциальных вычислений (Confidential Computing) добавляет защиту при обработке.
Подписка NVIDIA AI Enterprise в комплекте на пять лет
К H200 NVL прилагается пятилетняя подписка NVIDIA AI Enterprise. В неё входят инструменты для разработки и развёртывания генеративного ИИ, в том числе микросервисы NVIDIA NIM, которые ускоряют запуск моделей в продуктивной среде.
Это экономит недели настройки: вместо ручной сборки стека вы получаете проверенные компоненты, обновления и поддержку производителя. Особенно это ценно командам без выделенных ML-инженеров.
Ограничения: серверная карта требует подготовленной инфраструктуры
H200 NVL нельзя поставить в обычный офисный компьютер: нужен серверный корпус с подходящим питанием, продувом и свободными PCIe-слотами. Графических выходов для мониторов у такого ускорителя нет, он работает как вычислительный модуль.
Сравнивая с H100, учитывайте задачу. Если модели небольшие и память не является узким местом, выигрыш будет скромнее. Если вы упираетесь в объём памяти и скорость обмена данными, H200 даёт наибольший эффект. Перед заказом сверьте совместимость с вашим сервером и выбранной конфигурацией NVLink у поставщика.
| Модель | H200 NVL (PCIe) |
| Архитектура графического процессора | NVIDIA Blackwell |
| FP16 | BF16 Tensor Core | 1971 TFLOPS |
| FP8 Tensor Core | 3341 TFLOPS |
| TF32 Tensor Core | 835 TFLOPS |
| Память графического процессора | 141 ГБ |
| Производительность одинарной точности (FP32) | 60 TFLOPS |
| Пропускная способность памяти | 4.8 ТБ/с |
| FP64 Tensor Core | 60 TFLOPS |
оддерживаются CUDA, cuDNN, TensorRT, NCCL, а также виртуализация MIG (до 7 экземпляров на GPU) и конфиденциальные вычисления. В комплект обычно входит пятилетняя подписка NVIDIA AI Enterprise, однако состав поставки нужно уточнять у продавца. Гарантия и поддержка зависят от поставщика и производителя сервера (например, PNY, Dell, Lenovo, HPE). Лучше заранее проверить, что карта значится в списке совместимости вашего сервера и что у неё есть официальная гарантия. Для проекта Vizzion это важно при поставках для вузов и лабораторий ИИ.
Подходит для обоих сценариев, но сильнее всего проявляется в инференсе LLM и в HPC. Для обучения доступны Transformer Engine и FP8. Для масштабного обучения в крупных кластерах лучше использовать SXM с NVSwitch: у него выше TDP и более быстрая связь между всеми GPU узла. В NVL связь между картами быстрая только внутри группы из 2–4 карт, а за её пределами используется PCIe Gen5. Для дообучения и средних задач NVL подходит хорошо.
Официальной розничной цены NVIDIA не публикует. Ориентир по прайс-листам OEM — около 34,5–36 тыс. долл. США за карту. На маркетплейсах в 2026 году объявления начинались примерно с 50 тыс. долл. и выше. Цена зависит от поставщика, региона, наличия в складе и комплектации (мосты, сервер). Сроки и наличие нужно уточнять у поставщика, так как спрос на такие ускорители стабильно высокий. Поставка в РФ и страны СНГ может быть ограничена экспортными правилами и санкциями. Юридические вопросы лучше обсуждать с поставщиком.
Для работы одной карты мост не нужен. Он нужен, чтобы объединить несколько GPU с пропускной способностью до 900 ГБ/с на GPU, а это в разы быстрее, чем PCIe Gen5 (128 ГБ/с). Поддерживаются конфигурации из 2 и 4 карт. Мосты обычно продаются отдельно под своим артикулом. Например, у Lenovo 2-way и 4-way мосты идут под разными кодами. Перед заказом проверьте совместимость моста с конкретным сервером и расстоянием между слотами.
Карта пассивная: у неё нет собственных вентиляторов, поэтому обдув обеспечивает корпус сервера. Устанавливать её можно только в сертифицированные GPU-серверы с PCIe Gen5 x16, достаточной мощностью блоков питания и продуманным воздушным потоком. TDP — до 600 Вт, настраивается в диапазоне 450–600 Вт. Один сервер с 8 картами потребляет около 4,8 кВт только на ускорители. Дополнительное питание подключается через разъём 8-pin EPS. В обычный ПК или рабочую станцию карту ставить не стоит.
Хватит ли для больших языковых моделей? | На карте 141 ГБ HBM3e с пропускной способностью 4,8 ТБ/с. Этого хватает для инференса многих крупных моделей на одной карте, в том числе в квантованном виде. Если объединить 4 карты через NVLink, суммарно получится 564 ГБ памяти. Реальная вместимость зависит от точности (FP16, FP8, INT4), размера контекста и KV-кэша. Расчёт под конкретную модель лучше сделать до покупки.
Это двухслотовая PCIe-карта Gen5 с воздушным охлаждением. Она рассчитана на обычные серверные стойки. У неё та же память, что и у H200 SXM: 141 ГБ HBM3e с пропускной способностью около 4,8 ТБ/с. Отличается тепловой пакет: до 600 Вт против примерно 700 Вт у SXM. Из-за этого пиковая производительность вычислений у NVL ниже. NVIDIA заявляет, что по сравнению с H100 NVL карта быстрее до 1,7 раза в инференсе LLM и до 1,3 раза в HPC. SXM-версия нужна для плотных обучающих кластеров на платформе HGX с NVSwitch. NVL лучше подходит для инференса и смешанных задач в стандартных серверах.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования