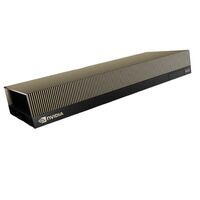
Графический ускоритель NVIDIA H200 SXM
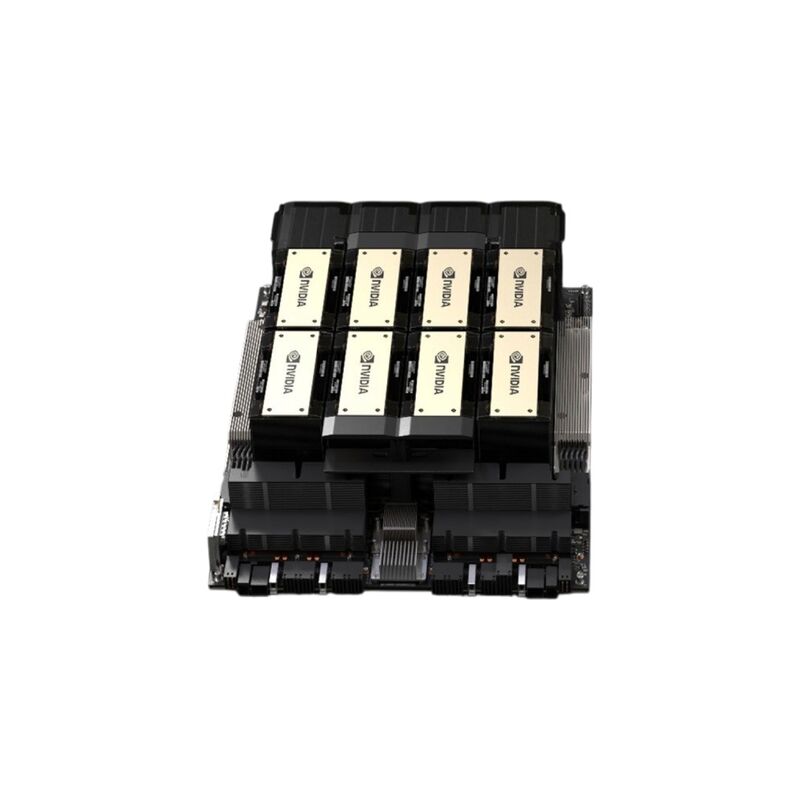
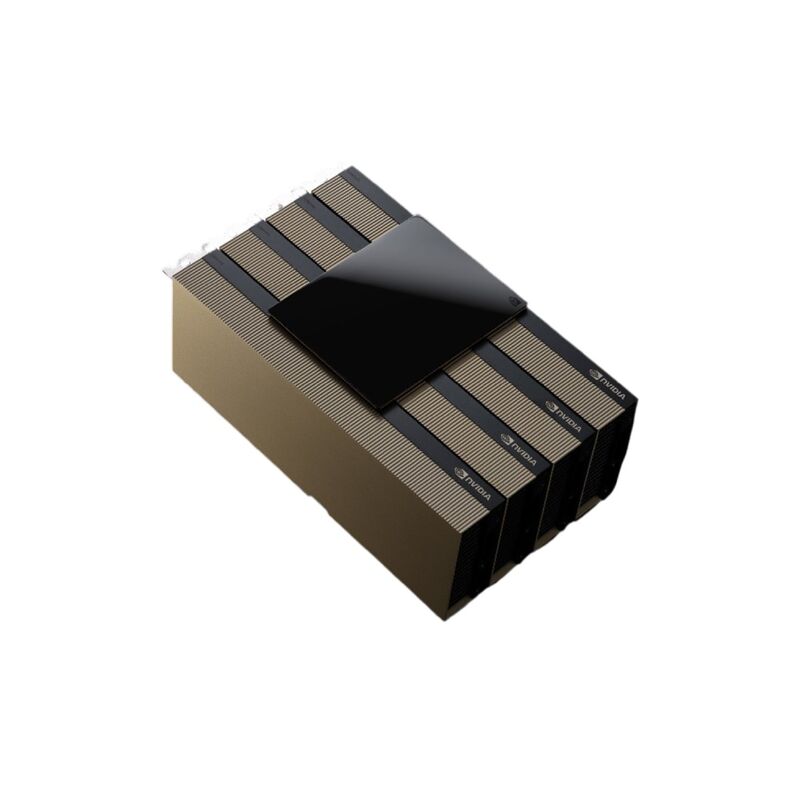
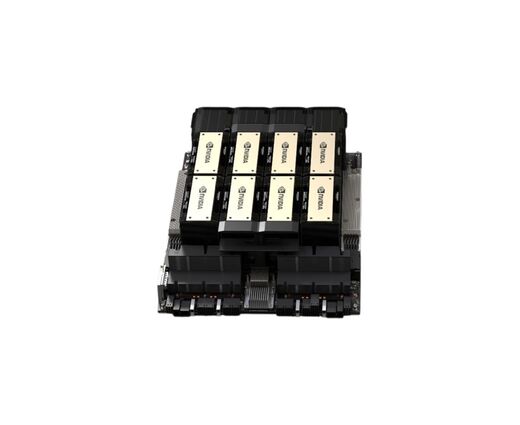
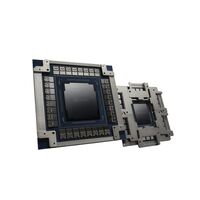
Графический ускоритель NVIDIA H200 SXM — вычислительный модуль корпоративного класса для обработки колоссальных объёмов данных в дата-центрах. Этот ускоритель, развивающий архитектуру Hopper, нацелен на задачи, где узким местом выступает не чистая производительность, а объём и скорость доступа к памяти. Для инженерных команд, занимающихся обучением больших языковых моделей или развёртыванием генеративного ИИ, H200 SXM снимает жёсткие ограничения, с которыми сталкивались при работе с предшественниками.
Сценарии применения в индустрии ИИ и образования
Модуль раскрывается там, где модели нужно одновременно держать в памяти огромные массивы весов и контекст длиною в десятки тысяч токенов. При дообучении специализированных LLM для образовательных платформ ускоритель позволяет разместить модель целиком в памяти, исключая дорогостоящие обмены с накопителями.
Для интеграторов интерактивных VR/AR-решений это означает возможность генерировать персонализированный учебный контент на лету. Когда ИИ-аватар преподавателя должен мгновенно реагировать на действия студента в симуляции, именно пропускная способность памяти определяет плавность отклика.
Архитектурный фундамент и работа с памятью
Ускоритель сохраняет ядро GH100, но критически меняет подсистему памяти. Использование стеков HBM3e ёмкостью 141 ГБ обеспечивает пропускную способность до 4,8 ТБ/с, что напрямую влияет на скорость вывода крупных моделей.
По сравнению с H100, здесь наблюдается существенный прирост как в ёмкости, так и в скорости обмена данными. Для разработчиков это выражается в заметном ускорении инференса при работе с длинными промптами: модель не «захлёбывается», перекачивая параметры из памяти в вычислительные блоки.
Интерконнект и масштабирование кластеров
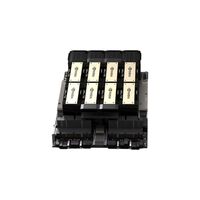
В серверных платформах ускорители объединяются в группы по восемь модулей через скоростную шину NVLink. Это позволяет представить несколько физических устройств как единую вычислительную среду, что критично при обучении моделей с сотнями миллиардов параметров.
Связка с коммутаторами InfiniBand даёт возможность строить многостоечные кластеры с минимальными задержками. Для исследовательских групп это путь от экспериментов на одном сервере к полноценному вычислительному комплексу без переписывания кода.
Реалистичные ограничения при внедрении
Оборотной стороной производительности остаётся тепловой пакет, достигающий внушительных значений при пиковой нагрузке. Стандартные серверные шасси с воздушным охлаждением часто не справляются с отводом тепла, из-за чего дата-центрам приходится переходить на системы жидкостного охлаждения или пересматривать архитектуру стоек.
Кроме того, развёртывание требует зрелой инженерной инфраструктуры: усиленных линий электропитания и специальных условий по температуре. Для небольших команд владение собственным железом часто уступает место аренде облачных инстансов, где инфраструктурные затраты уже распределены.
| Модель | H200 SXM |
| Архитектура графического процессора | NVIDIA Blackwell |
| FP16 | BF16 Tensor Core | 1979 TFLOPS |
| FP8 Tensor Core | 3958 TFLOPS |
| TF32 Tensor Core | 989 TFLOPS |
| Интерфейс памяти | 512-бит |
| Память графического процессора | 141 ГБ |
| Производительность одинарной точности (FP32) | 67 TFLOPS |
| Пропускная способность памяти | 4.8 ТБ/с |
| FP64 Tensor Core | 67 TFLOPS |
Прирост в обучении менее драматичен, чем в инференсе, но всё равно ощутим (в среднем на 10-20% для крупных моделей). Увеличенная пропускная способность памяти помогает быстрее обрабатывать огромные батчи данных и снижает время простоя вычислительных ядер в ожидании информации, что особенно полезно при тренировке трансформеров и моделей с длинным контекстом.
Да, поддерживается технология MIG (Multi-Instance GPU). Вы можете аппаратно разделить один физический модуль на несколько (до 7) изолированных инстансов с гарантированным объемом памяти и вычислительными ресурсами. Это идеальный вариант для среды разработки, CI/CD пайплайнов или предоставления ресурсов разным командам без потери производительности и с полной изоляцией.
Переписывать код не требуется, так как архитектура вычислительных ядер и набор инструкций идентичны предыдущему поколению Hopper. Однако для корректной работы с памятью HBM3e и достижения максимальной производительности необходимо обновить драйверы NVIDIA, использовать свежие версии CUDA Toolkit и соответствующие версии фреймворков (например, PyTorch 2.x+ с поддержкой Hopper).
В задачах генерации текста (инференс LLM) прирост может достигать 90-100% по сравнению с предыдущим поколением. Это происходит не из-за более быстрых ядер, а благодаря увеличенному объему памяти HBM3e и ее пропускной способности. Это позволяет загружать модели с большим количеством параметров без использования агрессивной квантизации и минимизирует задержки при чтении весов.
Энергопотребление (TDP) достигает 700 Вт на один модуль. Хотя пиковое потребление не превышает показатели топовых H100, суммарное тепловыделение 8-модульных базовых плат очень велико. Большинство плотных конфигураций требуют продвинутого воздушного охлаждения с высоким CFM или прямого жидкостного охлаждения (Direct Liquid Cooling). Перед закупкой обязательно проконсультируйтесь с интегратором по поводу теплопакета вашего ЦОД.
Переплата имеет смысл, если вы работаете с задачами, упирающимися в объем и скорость памяти. Главная особенность этой версии — 141 ГБ памяти HBM3e (на 76% больше) и пропускная способность 4.8 ТБ/с (на 43% выше). Это критически важно для работы с огромными языковыми моделями (LLM) и сложными HPC-задачами, где узким местом является именно передача данных, а не чистые вычисления.
Да, архитектура Hopper обеспечивает обратную совместимость. Ускорители являются drop-in заменой для большинства систем, сертифицированных под H100 SXM5. Вам не потребуется менять базовую плату или шасси, но перед апгрейдом обязательно проверьте поддержку конкретной модели сервера в списке совместимости производителя и обновите BIOS и микрокод.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования