Модуль ускорения ИИ Intel Gaudi 3 PCIe
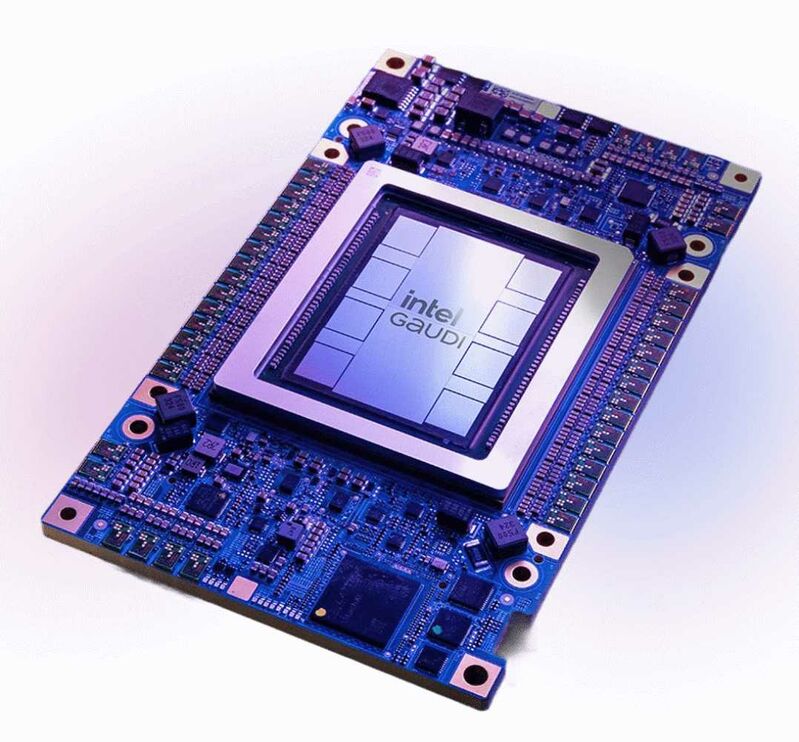
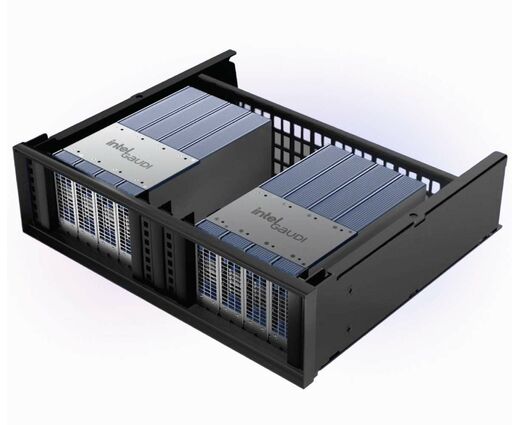
Модуль ускорения ИИ Intel Gaudi 3 PCIe (HL-338) — ускоритель в стандартном форм-факторе PCIe Gen5. Его ставят в уже существующие серверы и запускают на нём большие языковые модели, мультимодальные модели и корпоративный RAG. Подойдёт интеграторам, университетским ИИ-лабораториям и ИТ-командам компаний, которым нужны собственные вычисления для ИИ без перехода на закрытую инфраструктуру.
Установка в серверы с PCIe Gen5 без смены платформы
Карта HL-338 рассчитана на интеграцию в имеющиеся серверы, поэтому не требует специальной системной платы. Это экономит время на закупке и проектировании: ускоритель добавляют в парк, а не строят парк вокруг него.
Для образовательных проектов это означает следующее. Вуз или учебный центр может добавить ИИ-ускорение к серверу, который уже обслуживает VR/AR-классы, и запускать на нём языковую модель-ассистента для преподавателей или аналитику по учебным материалам.
Ethernet вместо закрытых интерконнектов при масштабировании
Gaudi 3 строится на стандартном Ethernet, поэтому для объединения ускорителей подходит сетевое оборудование, которое у организации уже есть. По данным Intel, это альтернатива закрытым технологиям вроде NVLink, NVSwitch и InfiniBand, от которых возникает зависимость от одного поставщика.
Intel также заявляет на 33% больше I/O-подключений на ускоритель по сравнению с H100 (1200 ГБ/с на открытом RoCE против 900 ГБ/с закрытого NVLink). Для проекта это значит, что на старте можно взять один сервер, а потом наращивать кластер, не меняя сетевую архитектуру. Intel даёт и референс-дизайн 32-узлового кластера на полностью Ethernet-фабрике.
Рост производительности относительно Gaudi 2
По заявлению Intel, Gaudi 3 даёт до 2x вычислений ИИ в FP8, до 4x в BF16 и до 2x пропускной способности сети по сравнению с Gaudi 2. Это «до»: на практике результат зависит от модели, конфигурации и нагрузки. Intel сама оговаривает, что показатели варьируются. Перед закупкой разумно прогнать на пилоте собственную модель.
Привычный стек: PyTorch и Hugging Face
Для разработки есть интеграция с PyTorch, а для переноса моделей — открытые инструменты, включая ресурсы Hugging Face. Команда, которая работала на GPU, может портировать существующие решения, не переписывая всё с нуля. Это сокращает путь от прототипа до промышленной эксплуатации.
Сценарии применения в образовании и бизнесе
Для вузов и центров ИИ-подготовки карта подходит как основа учебного вычислительного стенда: студенты дообучают открытые модели и запускают инференс на реальном ускорителе. Для компаний и интеграторов типичный сценарий — корпоративный RAG: ассистент отвечает по внутренней базе документов, а данные остаются внутри периметра.
- Дообучение и запуск LLM на локальном сервере.
- Мультимодальные модели: текст вместе с изображением.
- Интеллектуальные сервисы для интерактивных классов и умной электроники.
Ограничения: экосистема и подбор сервера
Gaudi 3 не заменяет GPU «один в один». Программный стек и инструменты отличаются от привычной экосистемы CUDA, поэтому часть моделей потребует адаптации и тестов. Сервер должен иметь подходящий слот PCIe Gen5 и достаточные питание и охлаждение; их требования уточняйте в документации HL-338. Совместимые серверные платформы выпускают партнёры Intel, среди которых Dell, HPE и Supermicro.
Технические характеристики Intel Gaudi 3 PCIe (HL-338)
| Характеристика | Значение |
|---|---|
| Форм-фактор | Двухслотовая плата расширения FHFL (Full-Height Full-Length) / PCIe CEM 5.1 |
| Интерфейс хоста (Подключение) | PCIe Gen 5.0 x16 |
| Объем памяти (VRAM) | 128 ГБ HBM2e (8 стеков по 16 ГБ) |
| Пропускная способность памяти | До 3,7 ТБ/с |
| Внутренняя кэш-память (SRAM) | 96 МБ интегрированного L2-кэша (Пропускная способность до 19,2 ТБ/с) |
| Пиковая производительность (FP8 / BF16) | До 1678 TFLOPS (Матричные вычисления) |
| Пиковая производительность (FP16 / TF32) | До 459 TFLOPS |
| Пиковая производительность (FP32) | До 229 TFLOPS |
| Архитектура ядер | 64 программируемых тензорных ядра TPC (VLIW SIMD) + 8 матричных движков MME |
| Сетевые интерфейсы (Scale-Out) | 24 встроенных порта Ethernet 200 GbE с поддержкой RoCE v2 прямо на чипе |
| Энергопотребление (TDP) | До 600 Вт |
| Тип охлаждения | Пассивное радиаторное (требуется внешний воздушный поток сервера) |
| Медиадекодеры | 14 аппаратных процессоров (H.265, H.264, JPEG, VP9) |
| AI-производительность: | 266 ТБ/с |
| FP16 | BF16 Tensor Core | До 459 TFLOPS |
| TF32 Tensor Core | До 229 TFLOPS |
| Интерфейсы | PCIe Gen 5.0 x16 |
| Количество ядер процессора | 64 |
| Максимальная производительность ядра RT | До 1678 TFLOPS (Матричные вычисления) |
| Модель | Intel Gaudi 3 PCIe |
Это модуль HL-338 в форм-факторе PCIe: полноразмерная двухслотовая карта длиной 10,5 дюйма с интерфейсом PCIe Gen5 x16. У неё 128 ГБ памяти HBM2e с пропускной способностью 3,7 ТБ/с, 8 матричных блоков (MME) и 64 тензорных ядра (TPC). Она поддерживает типы данных FP32, BF16, FP16 и FP8. Карта рассчитана на инференс LLM, мультимодальных моделей, корпоративный RAG, дообучение и обучение небольших моделей. Для обучения крупных моделей лучше подходят OAM-версия HL-325L и 8-картные узлы.
Заявленный TDP карты составляет 600 Вт. Охлаждение пассивное, поэтому серверу нужен продув корпуса, рассчитанный на такую карту. Нужны два свободных слота полной высоты и длины (FHFL) на PCIe Gen5 x16, а также блок питания и линии питания под 600 Вт на карту. Проверяйте совместимость с конкретной моделью сервера. Например, Dell PowerEdge XE7740 поддерживает до восьми таких двухслотовых карт на 600 Вт.
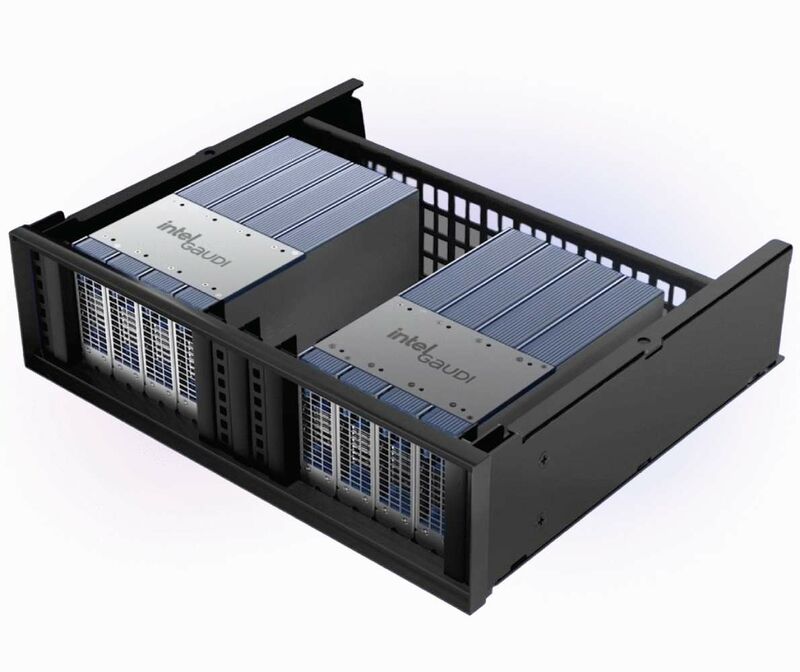
Карты объединяются стандартным Ethernet 200GbE, а не проприетарной шиной. В группу из 4 карт их соединяет специальная верхняя плата (top board) HLTB-304. Конфигурация с одной или двумя такими группами указана у Gigabyte. Между картами внутри группы получается до 18 × 200GbE. Для масштабирования между серверами (scale-out) используются внешние сетевые карты хоста. Платы и кабели нужно уточнять у поставщика сервера заранее.
Это специализированный ИИ-ускоритель, а не CPU и не видеокарта. Он работает вместе с хост-процессором сервера, например Xeon. CUDA не поддерживается. Нужен стек Intel Gaudi (SynapseAI/Gaudi Software) с PyTorch и vLLM. Код, написанный под CUDA, придётся адаптировать, хотя большинство PyTorch-моделей переносится с небольшими изменениями. Перед покупкой проверьте, что нужная вам модель работает на Gaudi.
Основное неудобство в том, что версии ПО Gaudi отстают от основных проектов. Известный пример из форума Intel: vLLM 0.9.0 и новее требует PyTorch 2.7, а на Gaudi с PyTorch 2.6 он не запускался. Пользователям приходилось брать более старые версии vLLM или форк Habana. Поддержка PyTorch 2.7 появилась в версии Gaudi SW 1.22.0. Документация vLLM для Gaudi также предупреждает, что не все функции основного vLLM поддерживаются текущими драйверами и прошивкой. Подбирайте версии драйверов, PyTorch и vLLM по матрице совместимости Intel.
Официальной цены на PCIe-карту нет, поставщики дают её по запросу. На 14.10.2026 в одном из листингов карта значилась как «нет в наличии, только по запросу». Для ориентира: в 2024 году Intel объявляла цену $125 000 за комплект из восьми OAM-ускорителей, это около $15 600 за карту. Это устаревшая цена и не относится к PCIe-версии. Карты обычно поставляются в составе серверов OEM-производителей, например Dell или Supermicro. Для России нужно отдельно уточнять возможность поставки, санкционные ограничения, гарантию и сервис у поставщика.
На одной карте 128 ГБ памяти. По оценке сервиса GetDeploying, этого хватает примерно на модель с 53 млрд параметров в 16 бит или около 199 млрд в 4 бит при контексте 32K. Для более крупных моделей объединяйте несколько карт. Intel позиционирует Gaudi 3 как более доступную альтернативу H100 по цене и по сетевым возможностям (на 33% больше портов ввода-вывода). Независимые данные о реальной производительности ограничены и зависят от задачи. Тестируйте именно свою модель и фреймворк. Экосистема и сторонние библиотеки у NVIDIA заметно шире.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования