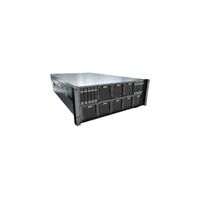
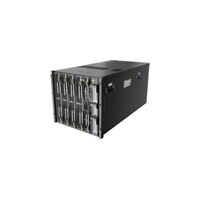
Сервер для ИИ Huawei Ascend Atlas 800I A3 с 8 NPU Ascend 910
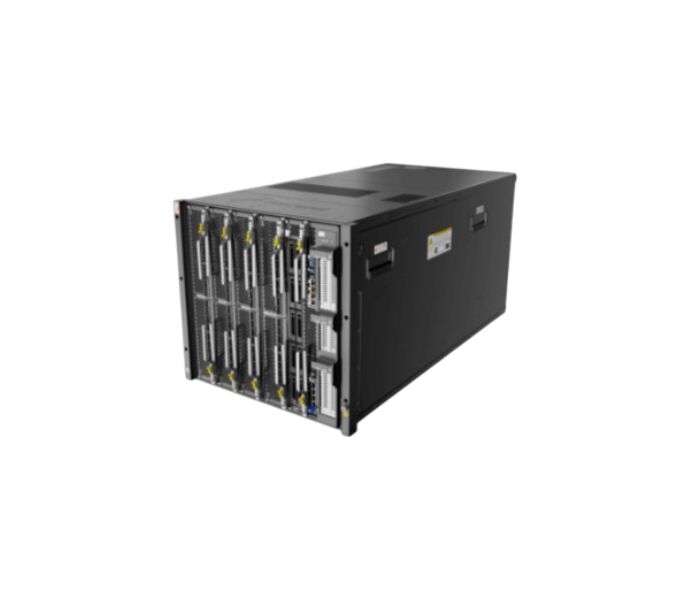
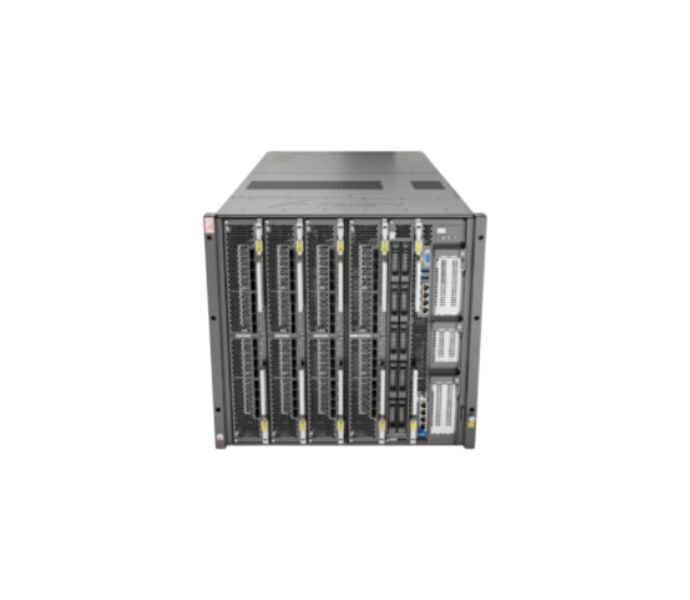
Ascend Atlas 800I A3 Server — это воздушно-охлаждаемый стоечный сервер Huawei для инференса больших языковых моделей. Он рассчитан на команды, которым нужно держать нейросети на собственной площадке: вузы, интеграторы, корпоративные ИТ-отделы. Сервер построен на ускорителях Ascend с двухкристальной архитектурой: 8 NPU показываются системе как 16 логических устройств. Платформа работает под управлением CANN и собрана на процессорах Kunpeng.
Что сервер делает в задачах инференса
Основная задача A3 — отдавать ответы языковых моделей многим пользователям одновременно. Это не учебный стенд на одного человека, а общий вычислительный ресурс.
Практический пример: модель среднего размера (класса 27–30 млрд параметров) в документации vLLM Ascend запускается на одном узле. Каждый запрос обслуживается небольшой группой NPU, а остальные карты берут параллельные очереди. Так один сервер раздаёт доступ целой кафедре или отделу разработки.
Сценарии для образования и бизнеса
Сервер подходит тем, кому нужен локальный контур: данные остаются внутри организации, а не уходят в облако.
- Вуз или университетский ИИ-центр: общий доступ студентов и исследователей к LLM, практика по развёртыванию моделей на отечественно ориентированном стеке.
- Интегратор или заказчик из госсектора, финансов, медицины: ассистенты, поиск по документам, модерация контента, где важна работа без внешнего интернета.
Для таких проектов Vizzion поставляет оборудование вместе с задачей: сервер, сеть, стойка и сценарии обучения подбираются как единый комплект.
Память и связность определяют размер моделей
Для LLM важнее объём памяти ускорителя и скорость обмена между картами, чем пиковые «попугаи». Чем больше памяти у NPU, тем крупнее модель помещается без дробления. Чем быстрее шина между картами, тем меньше простоев при распределённом запуске.
В открытых источниках встречаются конфигурации с 64 ГБ и 128 ГБ памяти на NPU. Для связи между ускорителями используется UnifiedBus, а наружу трафик выходит через сетевые порты 400GE. Точную конфигурацию уточняйте при заказе: от неё зависит, какие модели и с каким контекстом запустятся.
Ограничения при внедрении на стеке Ascend
Главный компромисс — экосистема. Вместо CUDA здесь CANN, поэтому код и модели нужно адаптировать, а версии драйвера, CANN и фреймворка должны совпадать.
Работа идёт через vLLM Ascend, MindIE и torch_npu. Поддерживаемые ОС — openEuler для ARM. Готовые x86-бинарники не запустятся, а сообщество заметно меньше, чем у NVIDIA.
Есть и физические требования. Сервер потребляет мощность на уровне кВт-класса, шумит и требует подготовленной линии питания и серверной стойки. В офис или класс его не поставить. Для небольших задач дешевле облако или менее мощные решения.
Ориентиры по конфигурации
Таблица ниже собрана из открытых источников и может отличаться в зависимости от поставки. Официальная страница Huawei по запросу показывает другую модель (Atlas 650E), поэтому её данные сюда не включены.
| Параметр | Ориентир |
|---|---|
| Ускорители | 8 NPU Ascend, двухкристальная схема (16 логических устройств) |
| Память NPU | варианты 64 ГБ или 128 ГБ на NPU |
| Процессоры | Huawei Kunpeng 920 (ARM) |
| Межкарточная связь | UnifiedBus, 784 ГБ/с (двунаправленная) на NPU |
| Сеть | 400GE от NPU напрямую |
| Питание | 6 горячезаменяемых блоков по 3,0 кВт, схема |
| Охлаждение | воздушное |
| ОС | openEuler для ARM |
| Интерфейсы | 5 хPCIe 5.0 |
| CPU | 4 × Kunpeng 920 |
| NPU | 8 × Ascend 910DT |
| Форм-фактор |
10U стоечный центр |
| Системная память |
32 слота памяти DDR5 скорость до 5200 М/с |
| Производительность | до 6.0 ПФЛОПС FP16, |
| Локальное хранилище | 2* 2.5 SATA + 8* 2.5 NVMe |
| Рабочая температура | от 5 ℃ до 35 ℃ |
| Модель | Ascend Atlas 800I A3 |
| Габаритные размеры (В*Ш*Г) | 442 х 447 х 920 мм |
| Питание | 6 × 3.0 кВт |
Сервер выпускается в вариантах 8×128 ГБ или 8×64 ГБ памяти на NPU, то есть около 1 ТБ или 512 ГБ суммарно. Пропускная способность памяти заявлена на уровне около 3,2 ТБ/с на NPU. В документации vLLM Ascend описан запуск на одном узле DeepSeek-V4.1-Flash (MoE, 552B параметров) в формате W8A8. Для самых крупных моделей, например класса 671B, может потребоваться несколько серверов. Это зависит от квантования и длины контекста.
Atlas 800I A3 — это инференсный сервер в корпусе 10U с воздушным охлаждением. В нём 8 NPU Ascend 910C (двухкристальная архитектура Da Vinci) и 4 CPU Kunpeng 920. Для 910C в справочных данных указана производительность около 560 TFLOPS FP16 на NPU и около 4,48 PFLOPS FP16 на весь сервер. Для сравнения, у обучающей версии Atlas 800T A3 заявлено около 750 TFLOPS на NPU. Часть источников указывает разные цифры для разных конфигураций, поэтому точный состав нужно уточнять в спецификации конкретной поставки.
Потребление достигает примерно 14,6 кВт. Питание обеспечивают шесть блоков по 3 кВт с резервированием , с горячей заменой. Охлаждение воздушное, корпус 10U. Нужна серверная стойка с подведённой мощностью, подходящими PDU и хорошей вентиляцией. Обычное офисное помещение или кабинет для такого сервера не подходит.
Каждый NPU подключён напрямую к сети через 8 портов 400GE QSFP-DD по RoCE. Кроме того, есть 56 портов 400GE по шинному протоколу UnifiedBus. Пропускная способность между NPU составляет около 784 ГБ/с в двух направлениях. Это позволяет объединять серверы в кластеры и использовать схемы распределённого инференса, например разделение этапов prefill и decode между узлами. Для этого нужны совместимые коммутаторы и кабели 400G.
Используется стек Huawei CANN. Из популярных инструментов поддерживаются vLLM Ascend, MindIE, LMDeploy и MindCluster для кластерного развёртывания. Это не CUDA, поэтому готовый код под NVIDIA обычно нужно адаптировать. Лучше всего оптимизированы популярные модели: Qwen, DeepSeek и некоторые другие. Остальные модели могут работать медленнее или требовать доработки. Перед покупкой проверьте, что нужная вам модель есть в списке поддерживаемых.
Разработчики оценивают инференс на Ascend 910C примерно в 60% от производительности NVIDIA H100. Это неофициальная оценка, и результат сильно зависит от модели и оптимизации ПО. Преимущества сервера — доступность в регионах, где сложно купить NVIDIA, и возможная экономия на энергии. При этом ПО и документация в основном китайские, а экосистема меньше. Условия поставки, гарантию, сертификацию и возможные экспортные ограничения нужно уточнять у поставщика до заказа.
Он ориентирован на инференс. В семействе Atlas 800 A3 для обучения предназначена модель 800T A3, у которой выше вычислительная мощность на NPU. На 910C выполнялось и дообучение крупных моделей, но это были кластеры из тысяч чипов. Если вам нужно обучение, лучше рассматривать 800T A3. Для запуска готовых LLM и мультимодальных моделей 800I A3 подходит.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования