Сервер для ИИ Ascend Atlas 800I A2 2UP Server
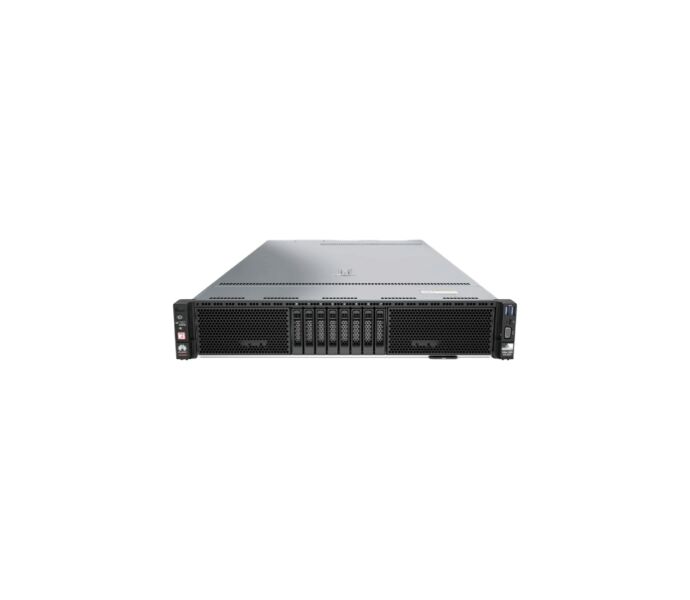
Сервер для работы с ИИ Ascend Atlas 800I A2 2UP Server — инференсный сервер Huawei из линейки Atlas 800I. Он рассчитан на запуск уже обученных нейросетей: языковых моделей, чат-ассистентов, анализа изображений и видео. Подойдёт вузам, колледжам, образовательным центрам и интеграторам, которым нужна собственная ИИ-инфраструктура внутри периметра организации. Данные остаются на своём оборудовании, а не уходят во внешнее облако.
Инференс на Ascend вместо облачных сервисов при работе с данными учебного заведения
Сервер выполняет готовые модели на ускорителях Ascend NPU, поэтому подходит для локального развёртывания ИИ-сервисов. Это снимает вопросы о передаче персональных данных студентов и материалов кафедр сторонним провайдерам.
Индекс «I» в названии означает inference, то есть запуск моделей, а не их обучение. Если задача — обучать модели с нуля, у Huawei для этого есть отдельная линейка с индексом «T». Для типичных образовательных и корпоративных задач инференса этого достаточно, и платить за обучающую платформу не нужно.
Сценарии: ИИ-ассистент для вуза и аналитика видео в кампусе
Два типовых сценария — локальный ИИ-помощник и обработка видео. В первом сервер обслуживает языковую модель: она отвечает на вопросы по учебным материалам, помогает готовить задания и обрабатывает документы. Во втором — разбирает потоки с камер и учебных VR/AR-классов.
- Образовательный центр разворачивает чат-ассистента для преподавателей и студентов. Запросы обрабатываются на сервере в серверной комнате вуза.
- Интегратор VR/AR-решений ставит сервер рядом с интерактивными классами. Он распознаёт жесты и объекты и анализирует аудиторию, а задержка остаётся низкой, потому что вычисления идут по локальной сети.
Программный стек: CANN, а не CUDA
Работа строится на стеке CANN от Huawei. Для запуска моделей используют инструменты вроде MindIE и vLLM Ascend. Это не экосистема NVIDIA, поэтому код, написанный под CUDA, обычно нужно адаптировать. Популярные открытые модели поддерживаются лучше всего, нишевые могут потребовать доработки и тестов.
Перед покупкой проверьте, что нужные вам модели и фреймворки есть в списке совместимости Huawei. Лучше проверить это на пилотном запуске, чем после монтажа в стойку.
Ограничения при размещении в обычном помещении
Серверы такого класса рассчитаны на серверную комнату или ЦОД, а не на кабинет. Они шумят из-за воздушного охлаждения, потребляют заметную мощность и требуют стойки с подходящим питанием. Заранее рассчитайте нагрузку на PDU и вентиляцию. Точный состав конфигурации — процессоры, память, накопители, сетевые карты — уточняйте у поставщика. Он зависит от поставки.
Подробные паспортные данные именно модели 2UP на официальной странице Ascend в открытом виде не отобразились. Поэтому ниже приведены вопросы, на которые стоит получить ответ в спецификации до заказа.
| Технические характеристики сервера Atlas 800I A2 2UP | |
|---|---|
| Форм-фактор | 2U стоечный сервер |
| НПУ (ИИ-ускорители) | Поддерживает 6 карт FHFL NPU мощностью 150 Вт (8 шт.) + 2 карты FHHL (Gen5 x16). |
| Процессор (CPU) |
Новая модель 920 (доступны два процессора):
|
| Вычислительная мощность ИИ | 2,24 PFLOPS FP16, 4,48 POPS INT8 |
| Системная память |
DDR5:
|
| Локальное хранилище | 8 портов SATA/SAS 2,5 дюйма, совместимых с 4 портами NVMe. |
| Источник питания | Резервирование основного источника питания по схеме 1+1 |
| Метод рассеивания тепла | С воздушным охлаждением |
| Рабочая температура среды | 5℃ ~ 35℃ (41℉ ~ 95℉) |
| Структурные размеры | Корпус глубиной 800 мм (86,1 мм × 447 мм × 798,5 мм) |
Что проверить в спецификации перед заказом
Эта таблица показывает, на какие параметры смотреть при выборе инференсного ИИ-сервера и почему они важны. Конкретные значения для вашей поставки берите из документации Huawei и коммерческого предложения.
| Параметр | Что это даёт на практике |
|---|---|
| Количество и модель NPU | Определяет, какого размера модель поместится и сколько запросов сервер обработает одновременно. |
| Память ускорителей | Чем её больше, тем крупнее модель и длиннее контекст можно запускать без дробления на несколько серверов. |
| Системная память и накопители | Влияют на скорость загрузки моделей и работу с большими наборами документов. |
| Сетевые интерфейсы | Нужны для связи с пользователями и объединения нескольких серверов в кластер. |
| Питание и охлаждение | Определяют, подойдёт ли ваша серверная и потребуется ли усиление электросети. |
| Поддерживаемое ПО | Задаёт, какие модели и фреймворки запустятся без доработки. |
| Интерфейсы | 3 хPCIe 4.0 |
| CPU | Новая модель 920- 7270Z (64C/2.9G/300W) , 7280Z (80C/2.9G/325W (опционально) |
| NPU | 6 карт FHFL NPU мощностью 150 Вт (8 шт.) + 2 карты FHHL (Gen5 x16) |
| Форм-фактор |
2U стоечный сервер |
| Системная память |
DDR5 5200 МТ/с при 1 DPC (максимум 16 шт.) |
| Производительность |
2.24 PFLOPS FP16 4.48 POPS INT8 |
| Локальное хранилище | 8 х SATA/SAS 2 |
| Рабочая температура | от 5 ℃ до 35 ℃ |
| Модель | Ascend Atlas 800I A2 2U |
| Габаритные размеры (В*Ш*Г) | 86.1 х 447 х 798.5мм |
Atlas 800I A2 — это сервер для инференса, то есть для запуска готовых моделей. Huawei относит его к сценариям инференса на одной машине и к масштабному инференсу на нескольких узлах. Для обучения и дообучения у Huawei есть отдельная версия Atlas 800T A2. Если вам нужны RAG, чат-боты или локальные LLM для вуза или компании, I-версия подходит. Если планируете обучать модели, смотрите T-версию.
В описаниях конфигурации указано 64 ГБ памяти на каждый NPU. Для больших моделей это ограничивает выбор. В открытых инструкциях сообщество разворачивало полноразмерную DeepSeek V3 на одном сервере, но только с квантованием W8A4 (смешанное 8/4 бит), через MindIE. Для этого нужно не менее 1,5 ТБ оперативной памяти сервера. Дистиллированные версии DeepSeek-R1, например на 14 млрд параметров, запускаются проще, и Huawei публикует пошаговый пример RAG-системы на Dify. Конкретную модель лучше проверить заранее по матрице совместимости Huawei.
Основной инструмент — MindIE (Mind Inference Engine), набор Huawei для ускорения инференса на Ascend. Готовый Docker-образ уже содержит CANN, адаптер PyTorch и MindIE, так что можно быстро запустить модель и поднять сервис с API. Есть и поддержка сторонних фреймворков: например, LMDeploy официально описывает развёртывание на Ascend. CUDA-код напрямую не работает. Скрипты и модели придётся адаптировать, а часть оптимизаций и новых архитектур доступна не сразу. Перед покупкой проверьте, что ваша модель есть в списке поддерживаемых.
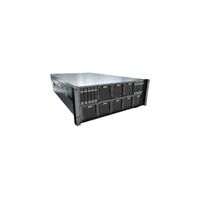
Это 4U-сервер полной глубины с воздушным охлаждением спереди назад. По данным справочника NetBox, его вес около 90 кг, поэтому для монтажа нужны подходящие направляющие и несколько человек или подъёмник. Размещать сервер нужно в серверной или ЦОДе, а не в учебном классе: шум и тепловыделение большие. Заранее проверьте нагрузку на стойку и мощность питания. Точные габариты и вес сверьте с документом Huawei для вашей поставки.
Для удалённого управления есть выделенный порт управления 1GE (BMC), через который можно настраивать сервер, не подключаясь к нему напрямую. Для данных используются порты Ethernet, а при объединении нескольких серверов нужны быстрые сетевые карты и коммутаторы. Для работы по API откройте на сервере нужные порты. В примере Huawei с RAG их требуется шесть: один для MindIE, три для моделей embedding и rerank и два для Dify. Параметры сети и безопасности согласуйте с вашим ИТ-отделом.
Да, при развёртывании больших моделей возникают типичные трудности. Нужно точно подбирать версии драйвера, CANN, MindIE и образа Docker. При запуске многокарточной модели увеличивают таймаут установки связи HCCL (в примере — 7200 секунд). Для экономии памяти NPU включают сборку фрагментов памяти и выделяют до 96% памяти. Большие модели нужно квантовать, а на это уходит время и требуются инструменты вроде msModelSlim. Закладывайте время на настройку и обращайтесь к поддержке поставщика или Huawei.
В открытой документации Huawei основная модель называется Atlas 800I A2, а обозначение «2UP» там не раскрывается. Скорее всего, это маркировка поставщика или конкретной комплектации. Не полагайтесь на название: запросите у продавца полную спецификацию с номером материала (P/N). В ней должны быть указаны число NPU, процессоры, объём и тип памяти, накопители и сетевые карты. У Huawei от конфигурации накопителей зависит, какие PCIe-слоты доступны и с какой пропускной способностью, поэтому состав комплектации важен для расширения.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования