
Серверы, ПК и комплектующие для ИИ
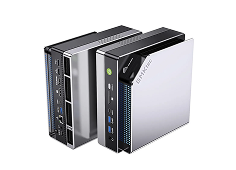
Артикул: 120-00013
Мини-ПК Beelink SER10 MAX AMD Ryzen AI 9 HX 470 (32GB/1TB)
Предзаказ
Цена по запросу
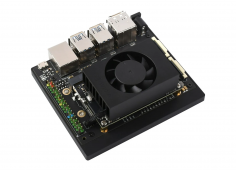
Артикул: 120-00014
Одноплатный компьютер Radxa Orion O6N Nano-ITX (32GB/ARMv9)
Предзаказ
Цена по запросу
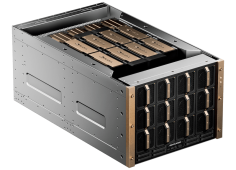
Артикул: 120-00005
Стоечный вычислительный комплекс NVIDIA GB200 NVL72 Platform
Предзаказ
Цена по запросу
Артикул: 120-00016
Суперкомпьютер с искусственным интеллектом Asus Ascent GX10
Предзаказ
Цена по запросу
Артикул: 120-00018
Суперкомпьютер с искусственным интеллектом Asus PE3000N (NVIDIA Jetson T5000)
Предзаказ
Цена по запросу
Артикул: 120-00020
Суперкомпьютер с искусственным интеллектом Dell Pro Max with GB10
Предзаказ
Цена по запросу
Артикул: 120-00021
Суперкомпьютер с искусственным интеллектом Lenovo ThinkStation PGX Small Form Factor Workstation
Предзаказ
Цена по запросу
Артикул: 120-00015
Суперкомпьютер с искусственным интеллектом NVIDIA DGX Spark
Предзаказ
Цена по запросу

Оборудование для ИИ: серверы, ПК и комплектующие для вычислений
Главный критерий выбора внутри категории — не бренд и не цена, а тип задачи: обучение модели с нуля, дообучение (fine-tuning) или инференс готовой нейросети. От этого зависит нужный объём видеопамяти, тип сети между узлами и бюджет на охлаждение, и подтип оборудования подбирается под задачу, а не наоборот.
Категория делится на три блока. ИИ-серверы — многокарточные платформы на 4–8 GPU уровня A100/H100 с NVLink между ускорителями, для обучения больших языковых моделей и HPC-нагрузок; такой узел требует отдельного расчёта питания и продува стойки. ИИ ПК и терминалы — компактные рабочие станции и edge-устройства с одной-двумя видеокартами или встроенным NPU, для локального инференса, дообучения небольших моделей и офлайн-задач компьютерного зрения без облака. Комплектующие для ИИ — видеокарты, платы расширения PCIe-NVMe, NVMe-накопители, блоки питания и материнские платы с достаточным числом линий PCIe, из которых собираются оба типа систем.
Принято считать, что для любой задачи ИИ нужен максимальный объём видеопамяти на карте — но для инференса готовой модели избыточная VRAM просто простаивает, увеличивая стоимость без прироста скорости отклика. Ограничение в том, что видеопамять определяет размер модели, которую можно загрузить целиком, а не скорость её работы после загрузки. Поэтому для инференса выбор смещается к картам с меньшей VRAM и хорошей пропускной способностью памяти, а объём 40–80 ГБ с NVLink оправдан только там, где несколько ускорителей совместно обучают одну модель.
| Параметр | Диапазон | На что влияет |
| Видеопамять (VRAM) | 16–80+ ГБ на ускоритель | Инференс — от 16 ГБ, обучение LLM — от 40–80 ГБ |
| Оперативная память узла | 256–512+ ГБ | Должна перекрывать объём видеопамяти всех GPU |
| Накопитель NVMe | 1–4+ ТБ, PCIe 4.0/5.0 | Хранение датасетов и весов моделей |
| Энергопотребление узла | 5–10 кВт на 8-GPU сервер | Расчёт питания и охлаждения стойки |
| Сетевой интерфейс | 25–100+ Гбит/с, RDMA/InfiniBand | Кластерное обучение на нескольких узлах |
Частая ошибка — считать процессор второстепенным элементом сборки. Число линий PCIe у CPU ограничивает, сколько ускорителей и NVMe-накопителей подключается одновременно, и слабый процессор становится узким местом даже при мощных видеокартах. Вторая ошибка — расчёт блока питания без запаса: суммарный TDP GPU, CPU и накопителей нужно умножать на 1,2–1,3 для покрытия пиковых нагрузок при обучении.
Для локального инференса, обучения и корпоративного сервиса ИИ нужен один и тот же тип оборудования?
Рабочая станция подходит для разработки и тестового инференса на 1-2 GPU, а сервер нужен для круглосуточного доступа, удалённого администрирования и роста до 4-8 GPU. Для обучения моделей важны объединение ускорителей и пропускная способность, тогда как для одиночного инференса достаточно PCIe Gen4 и сети 10-100 GbE.
Что теряется при выборе одной видеокарты вместо системы с 4-8 GPU?
Одна GPU ограничивает модель объёмом собственной VRAM и не ускоряет обучение крупной модели параллельно с другими картами. Система на 4-8 GPU распределяет вычисления и память между ускорителями через NVLink или NVSwitch, но требует серверного корпуса 2U-5U, питания до 12 кВт и усиленного охлаждения.
Какой объём видеопамяти закладывать, чтобы ИИ-модель не упиралась в память?
Объём VRAM должен превышать объём весов модели на 10-30%, поскольку память также занимают KV-кэш, контекст и фреймворк. Для инференса критичны формат весов и длина контекста: INT8 занимает меньше памяти, чем BF16, а контекст 128K требует заметно больше VRAM, чем 8K.
Где проходит граница между базовой рабочей станцией и производительным AI-сервером по бюджету?
Рабочие станции с 1 GPU и 64-128 ГБ RAM подходят для разработки, тестов и одиночных задач. Конфигурации с 256-512 ГБ RAM и 2 GPU рассчитаны на крупные датасеты и параллельные эксперименты, а серверы с 4-8 GPU добавляют масштабирование, резервное питание и инфраструктурные интерфейсы.
Как не ошибиться с питанием и охлаждением при покупке оборудования для ИИ?
Тепловыделение GPU составляет 300-600 Вт на карту, поэтому нельзя рассчитывать питание только по числу ускорителей. К сумме TDP GPU, CPU, NVMe и вентиляторов добавляют запас 20-30%; при плотности свыше 20 кВт на стойку требуется жидкостное охлаждение, иначе возникает троттлинг.