Стоечный вычислительный комплекс NVIDIA GB200 NVL72 Platform
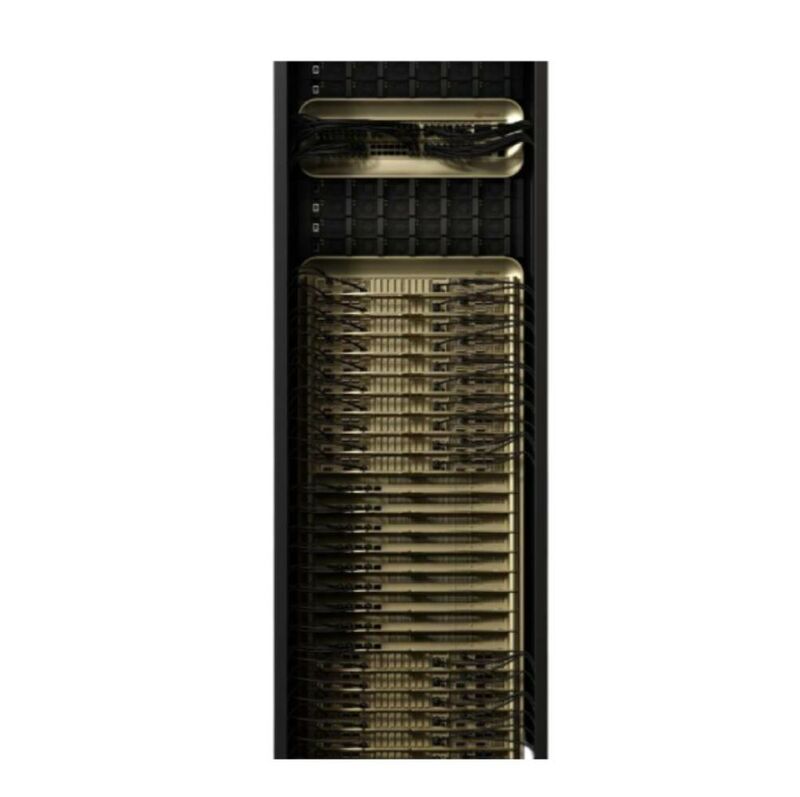
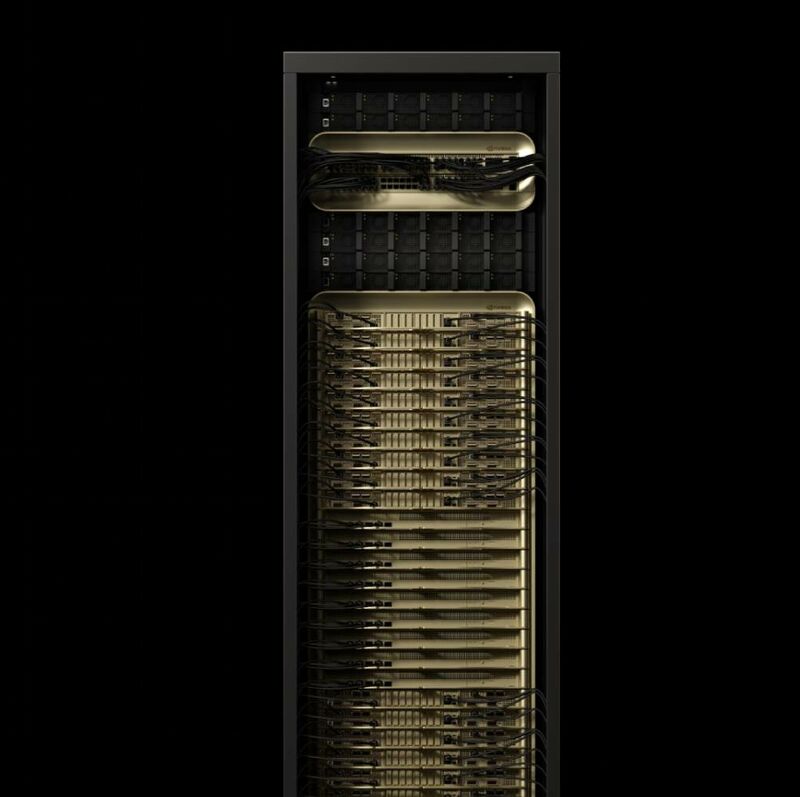
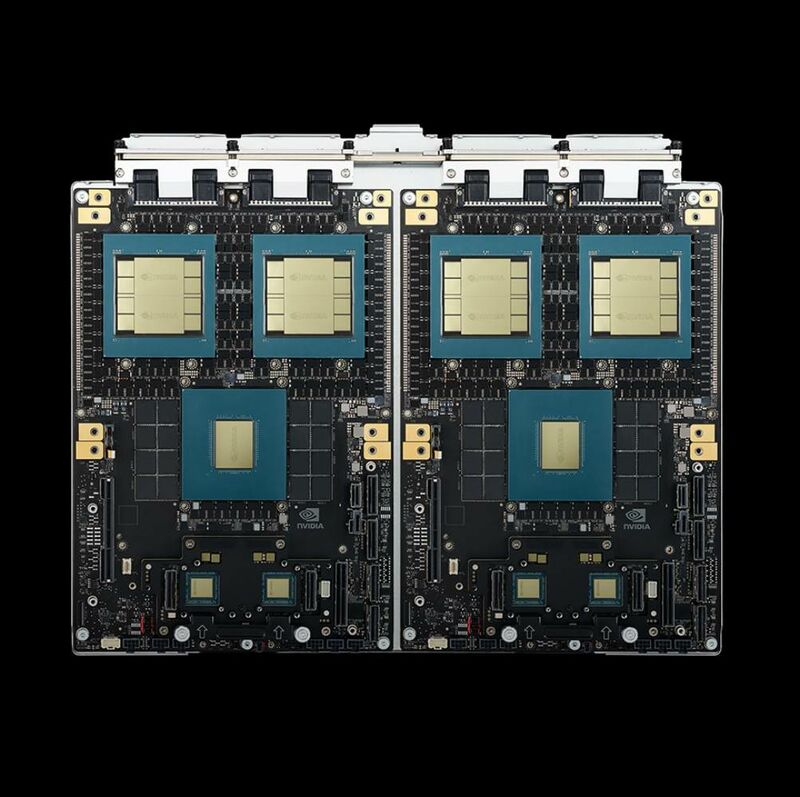
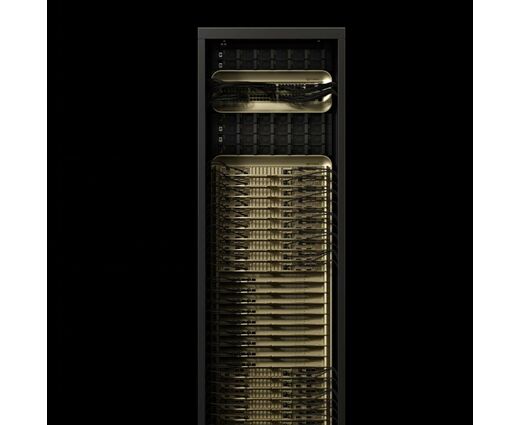
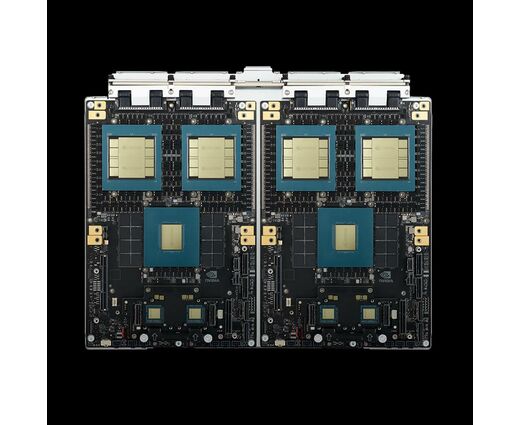
Стоечный вычислительный комплекс NVIDIA GB200 NVL72 — это целая стойка с жидкостным охлаждением, которая объединяет 36 процессоров Grace и 72 GPU Blackwell в одну систему. Она нужна компаниям, университетам и научным центрам, которые запускают и обучают модели масштаба триллиона параметров на собственной площадке. Все 72 GPU работают в общем домене NVLink и ведут себя как один огромный ускоритель.
Один домен NVLink на 72 GPU: 130 ТБ/с связи
Пятое поколение NVLink связывает все ускорители стойки, и обмен данными между ними не упирается в сеть. По данным NVIDIA, суммарная пропускная способность составляет 130 ТБ/с, а между двумя GPU — 1,8 ТБ/с.
Представьте оркестр, где каждый музыкант слышит всех остальных без задержки. В обычном кластере музыканты сидят в разных залах и передают ноты по почте. Для больших языковых моделей такая разница критична: обмен данными между GPU часто тормозит вычисления сильнее, чем нехватка мощности.
До 30x быстрее инференс LLM по сравнению с H100
NVIDIA заявляет для GB200 NVL72 до 30-кратного ускорения инференса языковых моделей на триллион параметров в реальном времени и до 4-кратного ускорения обучения относительно H100. Для MoE-архитектур заявлен 10-кратный прирост.
За это отвечают вторая версия Transformer Engine с поддержкой FP4 и FP8, а также новые Tensor-ядра. Цифры получены в конкретных условиях теста и являются проекцией, поэтому в своих задачах результат будет другим. Для провайдера ИИ-сервиса вывод простой: больше запросов на то же оборудование и ниже стоимость ответа.
Жидкостное охлаждение даёт 25x производительности при той же мощности
Жидкостное охлаждение повышает плотность вычислений и сокращает занимаемую площадь. NVIDIA сообщает о 25-кратном выигрыше в производительности при той же мощности по сравнению с воздушной инфраструктурой на H100, а также о меньшем расходе воды.
Суперчип GB200 соединяет два GPU Blackwell и процессор Grace через канал NVLink-C2C. Для обработки данных заявлено ускорение запросов к базам в 18 раз относительно CPU.
Сценарии: частный ИИ-контур и университетский центр
Комплекс подходит для двух типичных задач: корпоративного ИИ внутри компании и общего вычислительного ресурса для науки и обучения.
- Банк, промышленная или телеком-компания держит собственные LLM и ассистентов на своей площадке и не отправляет данные в облако.
- Университет или исследовательский центр даёт студентам и учёным доступ к тем же инструментам, которые применяет индустрия. Такой профиль близок задачам Vizzion по оснащению образования ИИ-оборудованием.
Сеть и управление: Quantum-X800, Spectrum-X800, Mission Control
Для масштабирования на сотни и тысячи GPU NVIDIA предлагает Quantum-X800 InfiniBand, Ethernet Spectrum-X800 и DPU BlueField-3. Работой «фабрики ИИ» управляет программная платформа Mission Control: она автоматизирует запуск нагрузок и повышает устойчивость инфраструктуры.
Если нужен следующий шаг по мощности, в линейке есть GB300 NVL72 на GPU Blackwell Ultra. Он ориентирован на рассуждающие модели и масштабирование на этапе инференса.
Ограничение: стойка требует подготовленного ЦОД
Жидкостное охлаждение означает, что обычная серверная комната не подойдёт. Нужны контур жидкостного охлаждения, подходящее электропитание и сетевая обвязка, поэтому проект начинается с обследования площадки.
Для небольших команд и экспериментов такая стойка избыточна: логичнее начать с серверов на базе HGX или с облачных ресурсов. Конфигурацию, сроки поставки и сопровождение стоит уточнять у поставщика до заказа.
| CPU | 36 процессоров Grace | 72 графических процессора Blackwell |
| Количество ядер процессора | 2592 ядра Arm® Neoverse V2 |
| Модель | NVIDIA DGX B300 |
| Оперативная память | 13.4 ТБ HBM3E |
| AI-производительность: |
FP32-760 ТФЛОПС FP64 -2880 ТФЛОПС |
Это стоечная система с 36 процессорами NVIDIA Grace (2592 ядра Arm Neoverse V2) и 72 графическими процессорами Blackwell. Все они объединены в единый домен NVLink пятого поколения с пропускной способностью около 130 ТБ/с. Объём памяти GPU составляет около 13,4 ТБ HBM3E (576 ТБ/с). Объём памяти CPU составляет около 17 ТБ LPDDR5X. По данным NVIDIA, производительность достигает 720 PFLOPS в FP8 и 1440 PFLOPS в NVFP4 (последняя цифра указана для разреженных вычислений). Система рассчитана на обучение и инференс моделей с более чем 1 трлн параметров.
Номинальная мощность стойки около 132 кВт, пиковая около 192 кВт (1,5 от номинала). В версии HPE питание идёт через 6 блоков питания (максимум 8) и шину постоянного тока. Каждый блок выдаёт до 33 кВт и подключается через кабель с разъёмом IEC 60309 560P6W. Это на порядок больше, чем у обычной серверной стойки, поэтому электрическую инфраструктуру нужно проектировать заранее. Для планирования часто берут значение около 120 кВт, но надёжнее ориентироваться на спецификацию конкретного производителя.
Нельзя. Жидкостное охлаждение здесь обязательно. Процессоры, GPU и коммутаторы NVLink охлаждаются через холодные пластины. По данным HPE, из 132 кВт около 115 кВт отводится жидкостью, а около 17 кВт воздухом. Нужны CDU (блок распределения охлаждающей жидкости) и контур технической воды в помещении. Например, CDU HPE мощностью 1,3 МВт обслуживает до 8 стоек. Обычный машинный зал без жидкостного контура не подойдёт.
Первые партии Blackwell в 2024 году обсуждались в прессе из-за проблем с перегревом и переработки конструкции стоек, но Dell и другие производители подтвердили, что поставки идут. Полевые отчёты по монтажу называют две типовые проблемы. Первая — перекос разъёмов медной магистрали NVLink при установке лотка, из-за чего связь NVLink собирается частично. Вторая — медленные утечки на быстроразъёмных соединениях при повторном использовании уплотнений. Нужны промывка контура, проверка давления и приёмка теплоносителя по требованиям производителя. Лучше поручать монтаж и пусконаладку сертифицированным специалистам.
Это готовая интегрированная стойка, а не отдельный процессор. Grace CPU и Blackwell GPU сидят на суперчипах GB200, которые установлены в вычислительные лотки. Отдельно закупить процессоры для самостоятельной сборки обычно нельзя. Стойки поставляют NVIDIA и партнёры, например HPE, Supermicro и Dell. Состав и условия поддержки у партнёров могут отличаться, поэтому уточняйте их в конкретной спецификации.
Технически да, но на практике почти всегда избыточна. Комплекс создан для обучения и инференса крупнейших моделей, а не для учебных классов или небольших лабораторий. Ему нужны специальный дата-центр, мощность около 130 кВт на стойку и жидкостное охлаждение. Для учебных курсов, VR/AR и локальных ИИ-задач обычно достаточно серверов с несколькими GPU или облачного доступа. Эту систему имеет смысл рассматривать для университетского суперкомпьютерного центра или национального проекта.
Публичной фиксированной цены нет. Стоимость зависит от поставщика, конфигурации, объёмов и условий поддержки, поэтому её нужно запрашивать у партнёров NVIDIA. Сама стойка составляет только часть бюджета. Дополнительно нужны CDU и водяной контур, усиление электропитания, сеть (InfiniBand или Ethernet), подготовка помещения с учётом веса стойки около 1,5 тонны, монтаж и сервис. Кроме того, поставки в Россию и ряд других стран ограничены экспортным контролем, поэтому до заказа проверьте возможность легальной поставки и гарантийной поддержки.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования