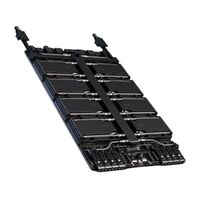
Серверная платформа NVIDIA HGX
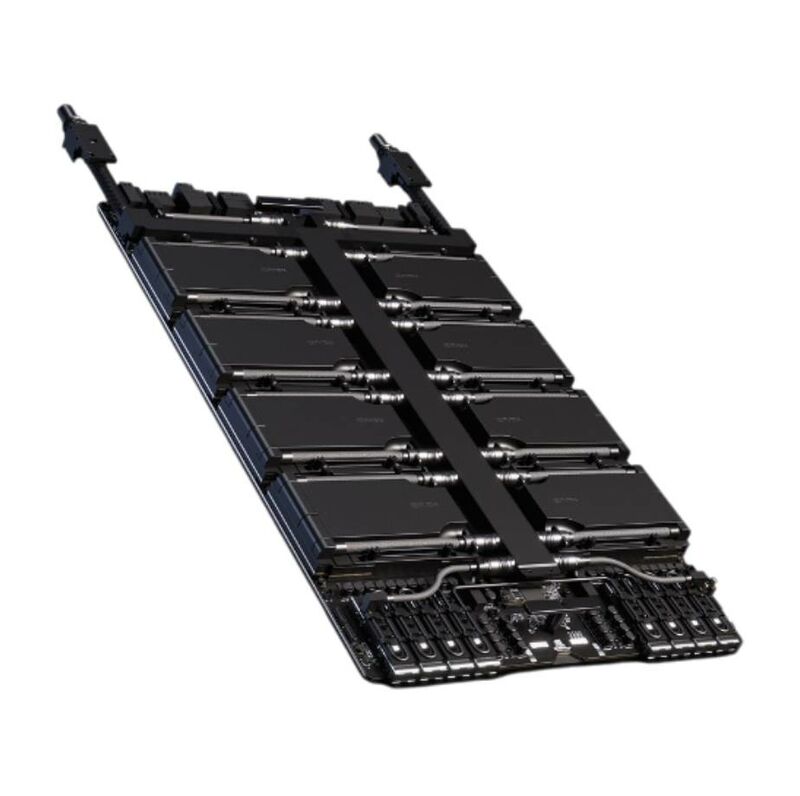
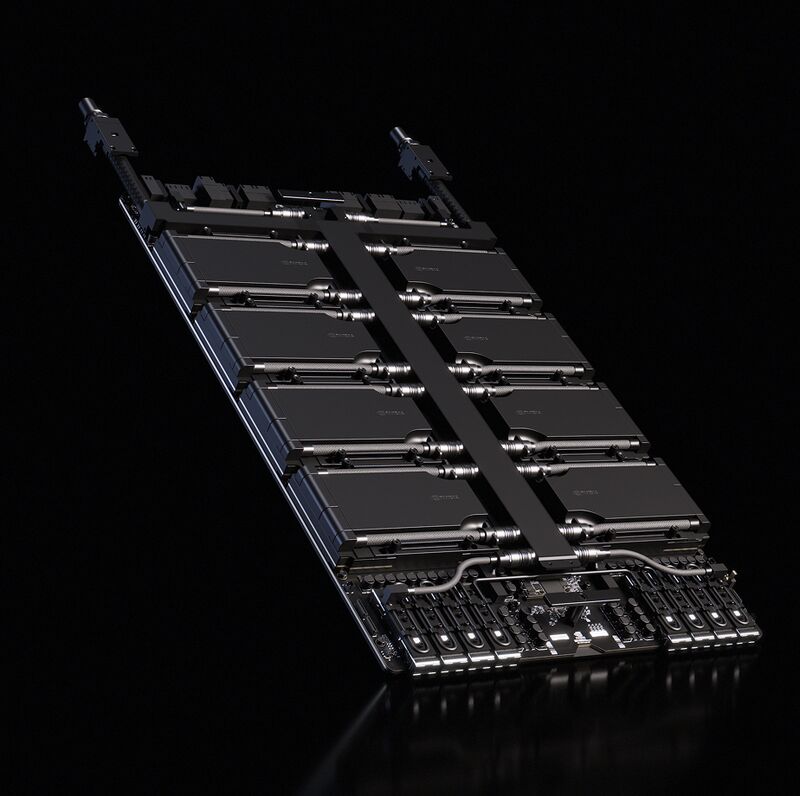
Серверная платформа NVIDIA HGX — это базовая плата с восемью GPU SXM, на которой OEM-производители собирают ИИ-серверы для ЦОД, университетов и исследовательских центров. Платформа объединяет GPU NVIDIA, процессоры Vera, интерконнект NVLink, сетевую часть NVIDIA и оптимизированное ПО для ИИ и HPC. Она подходит тем, кто обучает крупные модели, запускает инференс для многих пользователей или считает научные задачи на собственной площадке.
Одна плата, три поколения GPU: Rubin, Blackwell и Blackwell Ultra
HGX выпускается как единая плата с восемью GPU SXM архитектур Rubin, Blackwell или Blackwell Ultra. Поколение подбирают под задачу и бюджет, не меняя общую логику сервера.
Rubin-плату можно взять с процессором NVIDIA Vera (HGX Vera Rubin NVL8) или с x86-платформой. В линейке Blackwell на сайте производителя указаны HGX B200 и HGX B300, которые уже поставляются. Процессор и память в x86-вариантах определяет конкретный OEM-сервер, поэтому комплектацию стоит уточнять у поставщика.
HGX Rubin NVL8 даёт до 10x токенов в инференсе против HGX B200
По проекционным данным NVIDIA, HGX Rubin NVL8 обеспечивает до десятикратной пропускной способности «фабрики токенов» относительно HGX B200. Это важно для агентных ИИ-систем и reasoning-моделей, где один запрос порождает длинные цепочки генерации.
Цифры привязаны к конкретным условиям теста и могут измениться. Скорость растёт за счёт вычислений в формате NVFP4, пропускной способности памяти HBM4 и шины NVLink шестого поколения. Для провайдера ИИ-сервиса это означает больше пользователей на то же оборудование и меньшую стоимость токена.
Обучение MoE-моделей на HGX Rubin NVL8 требует в 4 раза меньше GPU
NVIDIA заявляет, что HGX Rubin NVL8 обучает модели следующего поколения с четырёхкратной экономией GPU по сравнению с HGX B200. Причины: больше NVFP4-вычислений для обучения, больше быстрой памяти HBM и шире NVLink.
Для лаборатории это выглядит так: та же задача решается меньшим парком ускорителей или за тот же бюджет обучается больше моделей. Приятный бонус — проще охлаждение и меньше места в стойках.
Сценарии: корпоративный ИИ-контур и университетский кластер
HGX подходит и для частного ИИ внутри компании, и для общего вычислительного ресурса вуза.
- Банк или промышленная компания держит собственные LLM и ассистентов на своей площадке, не отправляя данные во внешнее облако.
- Университет или научный центр собирает кластер для студентов и исследователей: одни учатся на тех же инструментах, что используют в индустрии, другие считают задачи HPC. Такой профиль близок задачам Vizzion по оснащению образования ИИ-оборудованием.
Сеть NVIDIA масштабирует HGX от одного сервера до тысяч GPU
Чтобы ускорители не простаивали, платформа опирается на сетевой стек NVIDIA: NVLink внутри узла, Quantum InfiniBand и Spectrum-X Ethernet между узлами, а также Spectrum-XGS для связи нескольких ЦОД. Инфраструктурные задачи берут на себя DPU BlueField и DOCA.
Практичный пример масштаба: NVIDIA и Noetra Corp. запускают в Японии ИИ-фабрику на Vera Rubin с 27 500 GPU Rubin и 13 750 процессорами Vera для национального проекта по физическому ИИ.
Ограничение: HGX — компонент сервера, а не готовая стойка
HGX не работает «из коробки» как отдельное изделие: это плата, и итоговые CPU, память, питание и охлаждение определяет сервер партнёра. Если нужна цельная система с управлением и поддержкой, ближе будут DGX или готовые кластерные решения.
Ещё один нюанс: проекционные показатели NVIDIA зависят от модели, длины контекста и формата вычислений. Перед закупкой разумно проверить их на собственной нагрузке и сверить совместимость со стойками ЦОД и сетью.
| CPU | 8 видеокарт NVIDIA Rubin SXM с односокетным процессором Vera |
| Количество ядер процессора | 88 собственных ядер NVIDIA Olympus | до 1.5 ТБ LPDDR5X |
| Модель | NVIDIA HGX |
| Оперативная память | 2 ТБ HBM4 | 130 ТБ/с |
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования