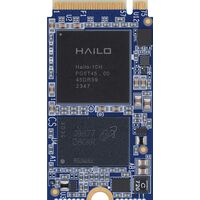
Модуль ускорения ИИ Hailo-10H M.2


Модуль ускорения ИИ Hailo-10H M.2 нужен разработчикам и интеграторам, которые хотят запускать на периферийном устройстве не только распознавание изображений, но и генеративные модели: LLM и VLM. Ускоритель даёт 40 TOPS в INT4 и 20 TOPS в INT8, а в слот M.2 встаёт как обычный накопитель. Обработка идёт локально, без облака и подписок.
Прямой интерфейс DDR позволяет работать с LLM и VLM
Hailo-10H подключается к внешней памяти LPDDR4/4X напрямую, поэтому ему доступны модели, которые не помещаются в память самого кристалла. У предшественника Hailo-8 такой возможности нет, и для языковых моделей он не подходит. Здесь появляется чат-ассистент, описание сцены по кадру и разбор документов на самом устройстве. Производитель называет Hailo-10H первым edge-ускорителем с поддержкой генеративного ИИ.
Типичная нагрузка чипа около 2,5 Вт
Чип потребляет в типовом режиме около 2,5 Вт, поэтому его ставят в компактные корпуса, где мощная видеокарта не поместится. Это сильное преимущество перед GPU: мини-ПК, киоск или шкаф с оборудованием не придётся переделывать под большой блок питания и шумный кулер. Тепло всё равно нужно отводить. В закрытом корпусе без обдува следите за температурой и при необходимости добавьте радиатор.
Индустриальный диапазон от −40 до 85 °C для встраиваемых систем
Чип выпускается в индустриальном и автомобильном исполнении. Индустриальный диапазон составляет от −40 до 85 °C, автомобильный — от −40 до 105 °C. Для школьного класса это избыточно, а для уличных киосков, камер и транспорта важно. Уточняйте, какое исполнение у конкретной партии модуля.
Как проект на PyTorch или ONNX попадает в модуль
Модели из TensorFlow, PyTorch, Keras, TensorFlow Lite и ONNX переносят через Dataflow Compiler от Hailo. Готовые примеры собраны в Model Zoo, и это сокращает путь от идеи до прототипа. Хост может быть на x86 или ARM, а ОС — Linux, Windows или Android. Для Raspberry Pi 5 у Hailo есть отдельное решение AI HAT+ 2 на этом же чипе, а M.2-версия подходит для плат и мини-ПК со слотом M.2.
Сценарии для образования и интерактивных решений
Для вузов и школ с VR/AR-классами модуль позволяет встроить в стенд голосового или визуального помощника, который работает офлайн и не отправляет данные учеников в облако. В классе с камерами тот же модуль решает задачи детекции и отслеживания людей и объектов. Для интегратора важна ещё и экономия на трафике и подписках на облачные ИИ-сервисы.
Ограничения при выборе для крупных моделей
Hailo-10H работает с компактными LLM, но не заменит серверный GPU. Размер модели упирается в объём подключённой памяти, а скорость генерации — в её пропускную способность. Цифры TOPS описывают пик, и реальный результат зависит от модели, квантования и остального железа. Перед закупкой партии проверьте свою модель на совместимость с компилятором. Если нужны только детекция и классификация, Hailo-8 обойдётся дешевле.
Характеристики ускорителя Hailo-10H
Данные взяты со страницы производителя и относятся к чипу Hailo-10H.
| Производительность | 40 TOPS (INT4) / 20 TOPS (INT8) |
|---|---|
| Память | LPDDR4/4X, прямой интерфейс DDR |
| Потребление | 2,5 Вт (типовое) |
| Температурные исполнения | Индустриальное: от −40 до 85 °C; автомобильное: от −40 до 105 °C |
| Фреймворки | TensorFlow, TensorFlow Lite, Keras, PyTorch, ONNX |
| Архитектура хоста | x86, ARM |
| Операционные системы | Linux, Windows, Android |
| Форм-фактор | M.2 |
| Модель | Hailo-10H M.2 |
| Поддерживаемые операционные системы |
Linux Windows Androi |
| Интерфейс памяти | LPDDR4/4X |
Используется HailoRT, а для генеративных моделей — HailoRT GenAI с API для LLM. Заявлена поддержка Linux, Windows и Android. Для запуска моделей с привычным интерфейсом есть hailo-ollama и проект hailo-apps для VLM. Для Raspberry Pi 5 часть инструментов выпускается в виде неофициальных форков, а часть возможностей, например VLM в hailo-ollama, на момент тестов в 2025 году не поддерживалась. Перед внедрением проверьте совместимость версии драйвера, ядра и HailoRT, а также пригодность проекта для вашей ОС.
Модуль выпускается в вариантах с 4 или 8 ГБ памяти LPDDR4/4X. Для Qwen2-1.5B в 4-битной квантизации заявлено около 1,2 ГБ, поэтому компактные модели помещаются и в 4 ГБ. Но 8 ГБ нужно, если вы хотите запускать VLM, держать несколько моделей одновременно или иметь запас на длинный контекст. Hailo указывает KV-кэш на 2048 токенов для Qwen2-1.5B. Для экспериментов и продукта с запасом на будущее разумнее брать версию 8 ГБ.
Типичное потребление составляет около 2,5 Вт. Отдельное питание не нужно, энергия поступает от слота M.2. Модуль рассчитан на промышленный температурный диапазон от −40 до 85 °C (проверьте это значение у конкретного поставщика). В открытом корпусе обычно хватает небольшого радиатора. В закрытом корпусе без воздухообмена при длительной нагрузке охлаждение лучше предусмотреть. Для LLM-нагрузки следите за температурой, так как она держит модуль занятым дольше, чем отдельные кадры.
Модуль выпускается в формате M.2 Key M (2242/2280) и работает по PCIe Gen3 x4. Нужен слот с PCIe, а не SATA-слот M.2. Проверьте длину платы и разводку линий на материнской плате. На Raspberry Pi 5 тот же чип Hailo-10H используется в готовой плате AI HAT+ 2 с 8 ГБ памяти. Для Pi это более простой вариант, чем M.2-модуль с переходником. Отзывы на форуме Raspberry Pi отмечают, что на многих LLM AI HAT+ 2 немного медленнее процессора Pi 5. Зато он разгружает CPU и ускоряет первый токен: 320 мс против 2039 мс на CPU по данным Hailo.
Hailo-8 (26 TOPS INT8) создан в основном для CNN-задач, то есть детекции, сегментации и трекинга, и своей DRAM не имеет. У Hailo-10H есть собственная память LPDDR4/4X объёмом 4 или 8 ГБ, а также поддержка трансформеров. Его пиковая производительность составляет 40 TOPS INT4 и 20 TOPS INT8. Типичное энергопотребление у обоих около 2,5 Вт. Если нужны только камеры и детекция объектов, Hailo-8 обычно достаточен и выгоднее. Hailo-10H берут, когда нужны LLM, VLM, распознавание речи (Whisper) или генерация на устройстве. Цифры TOPS у разных точностей напрямую сравнивать нельзя: 40 TOPS даётся для INT4, а для INT8 это 20 TOPS.
Пока нет. По отзывам пользователей и обзору Macnica, запускаются только модели, заранее скомпилированные Hailo, и их список небольшой. В 2025 году это были версии Qwen 1.5B и DeepSeek R1 Distill Qwen 1.5B. Дообучение через LoRA возможно. Классические модели компьютерного зрения можно компилировать самостоятельно через Dataflow Compiler. Перед покупкой сверьтесь с актуальным списком моделей в Hailo Model Zoo и на форуме Hailo.
Модуль рассчитан на небольшие LLM и VLM. По данным Hailo, Qwen2-1.5B-Instruct выдаёт около 9,45 токена/с, а время до первого токена составляет около 289 мс для 96 входных токенов. Для моделей около 1B–1,5B параметров community-замеры дают примерно 6–10 токенов/с. Ожидаемый потолок по размеру — порядка 10 млрд параметров, но на практике ограничивает память модуля и список готовых моделей. Для чат-бота, голосового ассистента или описания кадров этого хватает. Для больших моделей уровня ChatGPT он не подойдёт.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования