Модуль ускорения ИИ Hailo-10H


Модуль ускорения ИИ Hailo-10H переносит генеративный ИИ на устройство: языковые и визуально-языковые модели (LLM, VLM) работают локально, без облака. Он нужен разработчикам встраиваемых систем, интеграторам умных киосков и преподавателям, которые собирают учебные ИИ-стенды. Ускоритель развивает линейку Hailo-8: нейроядро второго поколения и прямой интерфейс к памяти дают запас для моделей, которые раньше требовали сервера.
Генеративный ИИ без облака: что это даёт на практике
Hailo-10H запускает модели прямо на устройстве, поэтому данные не уходят во внешние сервисы, а подписка на облачный ИИ не нужна. Производитель выделяет четыре выгоды: экономия трафика и денег, низкая задержка, работа офлайн и приватность.
Для образовательного класса это значит, что ИИ-ассистент или распознавание изображений продолжат работать при сбое интернета. Персональные данные учеников не покидают помещение. Такой подход проще согласовать со службой безопасности школы или вуза.
Прямой интерфейс DDR: почему Hailo-10H тянет LLM, а Hailo-8 нет
У Hailo-10H есть прямой интерфейс к внешней памяти LPDDR4/4X, и это главное отличие от Hailo-8. Чип Hailo-8 хранит всё внутри кристалла, поэтому подходит для зрения, но не для больших языковых моделей. Внешняя память снимает это ограничение: объём модели определяется установленной памятью, а не размером кристалла.
Производительность заявлена на уровне 40 TOPS в INT4 и 20 TOPS в INT8. Пиковые TOPS — лишь ориентир. Реальная скорость зависит от модели, квантования и от того, как хост готовит данные, так что на своей задаче модуль лучше проверить до закупки.
Расширенный температурный диапазон для промышленных и автомобильных систем
Платформа выпускается в промышленном (от −40 до 85 °C) и автомобильном (от −40 до 105 °C) исполнении. Это значит, что модуль переносит неотапливаемые шкафы, уличные терминалы и транспорт, где обычная электроника теряет стабильность.
Типичное потребление — 2,5 Вт. Для сравнения, это уровень небольшого светодиодного светильника, поэтому ускоритель можно ставить в компактные корпуса без шумных вентиляторов. В закрытом корпусе без воздухообмена всё равно стоит продумать отвод тепла.
Совместимость: фреймворки, ОС и процессоры
Модели переносят из TensorFlow, TensorFlow Lite, Keras, PyTorch и ONNX через Dataflow Compiler. Хост может быть на x86 или ARM, ОС — Linux, Windows или Android. Готовые модели для зрения и генеративного ИИ собраны в Model Zoo, а демо производителя включают ИИ-киоски самообслуживания и домашнюю автоматизацию.
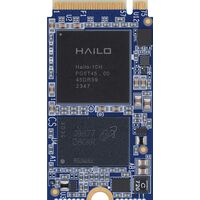
Для знакомства с платформой производитель предлагает стартовый набор: M.2-модуль с Hailo-10H для разработки и прототипов. Он же служит основой решений вроде Raspberry Pi AI HAT+ 2.
Сценарии применения в образовании и умных устройствах
- Учебная лаборатория: студенты запускают локальный чат-ассистент и распознавание объектов на одном ускорителе и сравнивают их по задержке и точности.
- VR/AR-стенд: модуль обрабатывает камеру или голосовые команды рядом с гарнитурой, без отправки видео в облако.
- Киоск самообслуживания: распознавание товаров и диалог с покупателем на месте.
Ограничения: это не замена серверной GPU
Hailo-10H рассчитан на компактные модели, прошедшие квантование. Большие LLM уровня дата-центра на нём не запустятся, а не каждая нестандартная архитектура сети компилируется без доработки. Для обучения моделей нужна отдельная вычислительная система: ускоритель отвечает только за вывод на устройстве. Кроме того, перед покупкой проверьте тип слота на плате и поддерживаемые версии драйвера и ПО.
Основные характеристики Hailo-10H
Ниже собраны параметры, которые производитель указывает на странице продукта.
| Производительность | 40 TOPS (INT4) / 20 TOPS (INT8) |
|---|---|
| Память | Прямой интерфейс LPDDR4/4X |
| Типичное потребление | 2,5 Вт |
| Промышленный диапазон температур | от −40 до 85 °C |
| Автомобильный диапазон температур | от −40 до 105 °C |
| Фреймворки | TensorFlow, TensorFlow Lite, Keras, PyTorch, ONNX |
| Архитектуры хоста | x86, ARM |
| Операционные системы | Linux, Windows, Android |
| Модель | Hailo-10H |
| Поддерживаемые операционные системы |
Linux Windows Android |
| Интерфейс памяти | LPDDR4/4X |
Подойдёт для учебных проектов по локальному ИИ: распознавание, голосовые помощники, чат-боты без облака. Данные остаются на устройстве, и это плюс для школ. Для старта нужны хост с подходящим слотом (M.2 Key M или Raspberry Pi 5), установленные драйвер и HailoRT на Linux и готовый пример. Самый простой вариант для класса — набор с Raspberry Pi 5 и AI HAT+ 2. Преподавателю нужны базовые навыки Linux и Python. Модуль не заменяет GPU для обучения моделей: он предназначен только для инференса.
У Hailo-10H до 40 TOPS в INT4 и 20 TOPS в INT8, а у Hailo-8 — 26 TOPS в INT8. Главное отличие в архитектуре: во втором поколении есть собственная DRAM и поддержка трансформеров и LLM. Для чистого компьютерного зрения выигрыш скромный. Raspberry Pi заявляет для AI HAT+ 2 сопоставимую со старым AI HAT+ (26 TOPS) производительность в задачах зрения. Если нужны только детекция и сегментация, Hailo-8 обычно выгоднее. Hailo-10H стоит брать, когда планируется генеративный ИИ или большой запас под новые модели.
Заявленные 40 TOPS — пиковое значение для INT4, и оно не равно скорости работы вашей модели. Реальная скорость зависит от размера модели, квантования, объёма памяти, обработки на процессоре хоста и пропускной способности шины. Hailo показывает на демонстрациях работу модели на 2 млрд параметров для описания сцен и поиска по тексту. Но это не тот уровень, как у ПК с видеокартой. Токены в секунду лучше измерить на своей модели до закупки партии. На форуме также есть сообщения о качестве вывода небольших моделей, например о зацикливании ответа у Qwen3 1.7B.
Готовые примеры есть, но произвольную модель придётся конвертировать. Для этого используют Dataflow Compiler (DFC) и среду HailoRT. Модель квантуется и компилируется в формат HEF, и бывают сложности. На форуме Hailo за последние недели описаны, например, ошибки компиляции YOLOv8 на больших разрешениях, проблемы с 16-битным режимом для трансформеров и сбои в HailoRT 5.4. Рассчитывайте на время, чтобы разобраться с инструментами, и сначала проверяйте модель на примерах из Model Zoo.
Бывает два основных варианта. Первый — M.2-модуль формата Key M (2242 и 2280) с 4 или 8 ГБ LPDDR4/4X. Второй — Raspberry Pi AI HAT+ 2 для Raspberry Pi 5, выпущенный в январе 2026 года, с 8 ГБ встроенной памяти. Память определяет, какие модели поместятся: для LLM и VLM разумнее брать 8 ГБ. Обратите внимание, что у разных поставщиков в характеристиках разная ширина шины: в одних источниках указано PCIe Gen3 x4, а в описании платы для Raspberry Pi 5 работа идёт через одну линию. Уточняйте это для вашей ревизии.
Можно и то и другое. Hailo-10H позиционируется как ускоритель генеративного ИИ для периферийных устройств. У него есть прямой интерфейс к памяти LPDDR4/4X объёмом 4 или 8 ГБ, поэтому на нём запускают LLM, VLM, Whisper и классические сети для зрения. Модели при этом небольшие: на практике это компактные LLM и VLM порядка 1–2 млрд параметров. Большие облачные модели не поместятся. Список готовых моделей смотрите в репозитории Hailo Model Zoo и в документации HailoRT.
Типовое потребление около 2,5 Вт, это сравнительно мало для ускорителя такого класса. Отдельное питание не нужно: энергия поступает из слота. При длительной нагрузке в закрытом корпусе лучше предусмотреть теплоотвод, то есть радиатор или контакт с корпусом, и следить за температурой. У промышленной версии заявлен диапазон от −40 до 85 °C. Для вашей модели проверьте рабочий диапазон в спецификации производителя.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования