Сервер для работы с ИИ Ascend Atlas 900 A3 SuperPoD


Сервер для работы с ИИ Ascend Atlas 900 A3 SuperPoD — жидкостно охлаждаемый суперузел Huawei, который объединяет до 384 NPU Ascend 910 в одну логическую вычислительную систему. Он рассчитан на дата-центры, где обучают и запускают крупные модели: операторов связи, финансовые организации, университеты и научные центры. Huawei заявляет до 300 PFLOPS вычислительной мощности. Для интегратора это основа ИИ-кластера, а не отдельный сервер в стойку.
До 384 NPU работают как один компьютер
Суперузел собирает 384 процессора Ascend 910 и до 192 процессоров Kunpeng 920 в единый вычислительный контур. Для программиста и планировщика задач это один большой ресурс, а не набор отдельных машин.
Обычный кластер из отдельных серверов теряет много времени на обмен данными между узлами. Здесь NPU связаны шиной Lingqu (UnifiedBus) с двусторонней пропускной способностью D2D 784 ГБ/с. Для сравнения: сеть между обычными серверами часто оказывается самым узким местом при обучении больших моделей, а в суперузле эту проблему снимает сама архитектура. Поддерживаются конфигурации логических узлов от 16 до 384 карт, поэтому ресурс можно делить между командами.
Память на кристалле: до 128 ГБ на NPU
Каждый NPU получает до 128 ГБ памяти на кристалле с пропускной способностью до 3,2 ТБ/с. Это определяет, какие модели поместятся без дробления на части. Дополнительно система поддерживает до 1536 модулей DDR5 по 64 или 96 ГБ.
Чем больше памяти рядом с вычислителем, тем реже данные ходят по сети. Для языковых моделей с сотнями миллиардов параметров это заметно сокращает простои ускорителей.
Состав: 12 вычислительных и 4 шинных шкафа
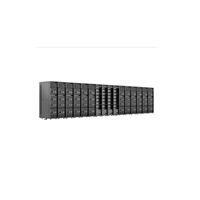
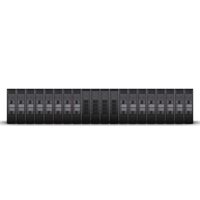
Система занимает 16 шкафов формата 47U: 12 вычислительных и 4 шинных. Вычислительные шкафы охлаждаются жидкостью, шинные — воздухом. Жидкостное охлаждение отводит тепло эффективнее воздуха, поэтому подходит для плотной компоновки и помогает снизить PUE дата-центра. Питание подаётся от трёхфазной сети 380 В, рабочая температура окружающей среды — от 5 до 40 °C.
Сценарии для образования и промышленности
Первый сценарий — университетский или региональный центр ИИ. Он обучает собственные большие языковые модели, а студенты и исследователи получают доступ к мощностям через планировщик задач. Второй сценарий — корпоративный центр инференса. Банк или оператор запускает на суперузле сразу несколько моделей для сервисов клиентов.
Для интегратора важна совместимость программного стека. Ascend работает через CANN, фреймворк MindSpore и адаптеры для PyTorch. Код, написанный под CUDA, напрямую не заработает, и модели придётся переносить и проверять.
Ограничения: инфраструктура и перенос ПО
Atlas 900 A3 SuperPoD не подходит для небольших лабораторий и учебных классов. Ему нужны машинный зал, подвод охлаждающей жидкости, мощное электропитание и оптическая коммутация между шкафами. Под проект закладывают подготовку площадки, пусконаладку и обучение специалистов. Перед закупкой уточните у поставщика состав поставки, сроки и условия поддержки.
Основные параметры суперузла
| Параметр | Значение |
|---|---|
| Форм-фактор | 12 вычислительных шкафов (47U) + 4 шинных шкафа (47U) |
| NPU | до 384 × Ascend 910 |
| CPU | до 192 × Kunpeng 920 |
| Системная память | до 1536 модулей DDR5, 5200 МТ/с, 64/96 ГБ |
| Память на кристалле | до 384 × 128 ГБ, до 3,2 ТБ/с |
| Производительность | до 307,2 / 288,7 PFLOPS (FP16) |
| Интерконнект D2D | 784 ГБ/с (двусторонний) |
| Питание | трёхфазное 380 В AC, два ввода |
| Охлаждение | жидкостное (вычислительные шкафы) + воздушное (шинные) |
| Рабочая температура | 5–40 °C |
| CPU | до 192 × Kunpeng 920 |
| NPU | до 384 × Ascend 910 |
| Форм-фактор | 12 вычислительных шкафов (47U) + 4 шинных шкафа (47U) |
| Системная память |
до 1536 модулей DDR5 5200 МТ/с 64/96 ГБ |
| Производительность |
до 307.2 288.7 PFLOPS (FP16) |
| Рабочая температура | 5–40 °C |
| Модель | Ascend Atlas 900 A3 SuperPoD |
| Питание |
трёхфазное 380 В AC два ввода |
Huawei представила линейку Atlas 950 и 960 на базе чипов Ascend 950 и 960. Atlas 950 SuperPoD рассчитан примерно на 8192 чипа, это в 20 раз больше, чем в A3. Atlas 900 A3 остаётся актуальным решением. Он уже развёрнут в более чем 1000 экземплярах и работает в телекоме, финансах и промышленности. Но новое поколение заметно мощнее. Если проект рассчитан на много лет, уточните у поставщика план обновления, совместимость и поддержку.
Подключение — трёхфазное, 380 В переменного тока, с двумя вводами. Вычислительные шкафы охлаждаются жидкостью, шинные — воздухом. Рабочая температура окружающей среды — от 5 до 40 °C. Значит, нужен подготовленный машинный зал с контуром жидкостного охлаждения и мощной электрической инфраструктурой. Точные показатели потребляемой мощности и требования к жидкости уточняйте в конфигурационном руководстве Huawei для вашей конфигурации.
Это продукт компании Huawei, который поставляется по проектной схеме, через официальных партнёров и под заказ. Публичной розничной цены нет. Huawei сообщает о более чем 1000 развёрнутых систем Atlas 900 A3, но покупатели в основном находятся в Китае. На поставки Huawei влияют американские экспортные ограничения, а ограничения ЕС и России могут меняться. Перед сделкой проверьте условия поставки, гарантии, сервисную поддержку и санкционные требования для вашей страны. Выясните это у юристов и у поставщика.
Основа программной части — набор CANN и фреймворк MindSpore. Есть и конвертация моделей из PyTorch и TensorFlow. Для Atlas A3 Huawei выпускает руководства по установке драйверов и прошивок NPU, а также по настройке виртуальных машин. В качестве ОС документированы openEuler на ARM. Перенос кода, рассчитанного на CUDA, потребует адаптации и тестирования. Часть библиотек и кастомных операторов может отсутствовать. Перед покупкой проверьте свои модели на тестовом стенде.
По данным Huawei, пиковая производительность — 307,2 PFLOPS в FP16 (в других материалах указано 288,7 PFLOPS). В системе до 384 NPU, у каждого 128 ГБ памяти HBM с пропускной способностью до 3,2 ТБ/с. Общий пул памяти — около 48 ТБ. Двусторонняя пропускная способность между устройствами — 784 ГБ/с. Это пиковые значения из документации. Реальная скорость зависит от модели, ПО и настройки кластера.
Все 384 NPU соединены по принципу «каждый с каждым» через собственную шину Huawei (Lingqu / MatrixLink). Благодаря этому система работает как единый компьютер. Huawei заявляет, что пропускная способность связи выросла в 15 раз по сравнению с традиционными кластерами, а задержка одного перехода снизилась с 2 мкс до 200 нс. Компания также сообщает о десятках процентов преимущества при обучении моделей с сотнями миллиардов параметров. Эти цифры указаны производителем, независимых проверок в найденных источниках нет. Выигрыш заметен в основном на очень крупных моделях.
Это не одиночный сервер, а масштабный «суперузел» (SuperPoD) для дата-центра. Он состоит из 16 шкафов: 12 вычислительных и 4 шинных, по 47U каждый. Размер каждого шкафа без дверей — 2250×600×1150 мм. В системе до 384 NPU Ascend 910 и до 192 процессоров Kunpeng 920. Для небольших лабораторий и учебных классов такая система избыточна. В этом случае разумнее рассматривать серверы Atlas меньшего масштаба или отдельные ускорители.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования