Модуль ускорения ИИ Huawei Ascend 950PR 128 ГБ
Модуль ускорения ИИ Huawei Ascend 950PR — это NPU-ускоритель для инференса: он запускает уже обученные нейросети в сервисах и приложениях. Он нужен командам, которые разворачивают языковые и мультимодальные модели, и интеграторам, которые строят для вузов и лабораторий вычислительную базу под образовательные ИИ-проекты. Чип относится к семейству Ascend 950 и рассчитан на стадию prefill и на рекомендательные системы.
Для каких задач предназначен Ascend 950PR
Ascend 950PR ориентирован на инференс: быстро обработать длинный запрос и выдать ответ, а не обучать модель с нуля. Для обучения у Huawei есть отдельный чип Ascend 950DT.
Практический пример: университет поднимает свой чат-ассистент для студентов на открытой языковой модели. Модель отвечает на вопросы по курсам, анализирует изображения и текст. Для такой нагрузки нужен именно ускоритель инференса. Второй пример: ИИ-модуль для VR/AR-класса, где мультимодальная модель разбирает картинку с камеры и подсказывает ученику следующий шаг.
Память HiBL 1.0 снижает зависимость от импортной HBM
В 950PR Huawei впервые применила собственную высокоскоростную память HiBL 1.0. По открытым данным, её объём составляет 128 ГБ, а пропускная способность — около 1,6 ТБ/с. Часть источников называет для платы Atlas 350 объём 112 ГБ, поэтому точную конфигурацию лучше уточнять у поставщика.
Для покупателя это значит, что большая модель с длинным контекстом лучше помещается в память одного ускорителя. Меньше приходится дробить её между картами, а это упрощает развёртывание.
Низкая точность вычислений ускоряет работу моделей
Ascend 950PR поддерживает форматы с пониженной точностью, включая FP8 и FP4, а также MXFP8, HiF8, MXFP4 и HiF4. Заявленный пик — порядка 1 PFLOPS в FP8 и до 2 PFLOPS в FP4, при этом в разных публикациях цифры немного отличаются. Сжатые форматы — как архив для чисел: модель занимает меньше места и считается быстрее, а качество ответов при грамотной квантизации остаётся приемлемым.
Среди китайских чипов 950PR выделяется тем, что поддерживает такой режим расчётов. Huawei также сообщает об адаптации линейки Ascend SuperNode под модели DeepSeek V4.
Что понадобится вокруг ускорителя
Одной платы мало: нужны сервер с подходящим форм-фактором, мощное питание и охлаждение. Сам чип работает в составе плат вроде Atlas 350 и в крупных кластерах Atlas 950 SuperPoD. Программная часть строится на стеке CANN и фреймворках вроде PyTorch. По сообщениям, 950PR лучше предыдущих поколений совместим с экосистемой CUDA, но перенос проекта всё равно требует проверки.
Ограничения при выборе для образовательных проектов
Ascend 950PR — решение дата-центрового класса, и для небольшого класса или одного приложения оно избыточно. Цена официально не опубликована: в прессе называют около 111 тысяч юаней за ускоритель. Экосистема Ascend уже, чем у Nvidia: часть библиотек придётся адаптировать, а независимые тесты показывают эффективность на уровне конкурентов, но не заметно выше. Если нагрузка небольшая, дешевле взять готовый ИИ-сервис или менее мощный ускоритель.
Перед заказом уточните у поставщика точную модификацию, объём памяти, форм-фактор и условия поставки.
| Технические характеристики | Huawei Ascend 950PR |
|---|---|
| Количество ядер куба | 32 / 28 |
| Количество векторных ядер | 64 / 56 |
| Суммарная вычислительная мощность (Cube + Vector) | |
| MXFP4 | 1784 / 1561 TFLOPS |
| HiF8 / MXFP8 / FP8 | 919 / 804 TFLOPS |
| INT8 | 919 / 804 TOPS |
| BF16 / FP16 | 486 / 425 TFLOPS |
| TF32 | 243 / 212 TFLOPS |
| Вычислительная мощность куба (Cube) | |
| MXFP4 | 1730 / 1513 TFLOPS |
| HiF8 / MXFP8 / FP8 | 865 / 756 TFLOPS |
| INT8 | 865 / 756 TOPS |
| BF16 / FP16 | 432 / 378 TFLOPS |
| TF32 | 216 / 189 TFLOPS |
| Мощность векторных вычислений (Vector) | |
| FP16 / BF16 | 54 / 47 TFLOPS |
| FP32 | 27 / 23 TFLOPS |
| INT8 | 54 / 47 TOPS |
| INT16 | 27 / 23 TOPS |
| INT32 | 13 / 11 TOPS |
| INT64 | 6 / 5 TOPS |
| Подсистема памяти и управляющий процессор | |
| Объём памяти | 128 / 112 ГБ |
| Пропускная способность памяти | 1.6 / 1.4 ТБ/с |
| AI CPU Subsys | Linx816, 8C16T / 6C12T / 4C8T (с поддержкой NEON) |
| Кэш L2 (Емкость) | 128 / 112 МБ |
| Конфигурация кэша L2 |
|
| Сетевые интерфейсы и шины обмена | |
| Единая шина пропускной способности (UB) | 18-портовый, 112 Гбит/с, 2016 Гбит/с двунаправленный (Скорость выхода кадра ограничена оптическим модулем) |
| UBoE (Unified Bus over Ethernet) | 2 порта, 2 порта по 400 Гбит/с (Использует 2 порта совместно с UB) |
| ПКл (PCIe интерфейс) | PCIe 5.0 x16, двунаправленный, 128 ГБ/с (Использует 4 порта совместно с UB) |
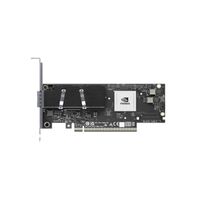
Ускоритель выпускается в виде карты Atlas 350 (PCIe/OAM) и рассчитан на серверы Huawei и партнёров. Для кластеров используется собственное соединение LingQu/UnifiedBus. В суперузлах Atlas 950 SuperPoD заявлено до 8192 чипов. Совместимость с вашим сервером (слот, питание, охлаждение, прошивки, драйверы) нужно проверять заранее по списку совместимого оборудования. Типовой сервер общего назначения для него, скорее всего, не подойдёт.
Официальных розничных цен на российском рынке в найденных источниках нет. Ориентир по Китаю для Atlas 350 составляет около 111 000 юаней (примерно 16 000 долларов). В России поставка возможна только под заказ, а цена и сроки зависят от канала поставки. Уточните у поставщика наличие, гарантию, сервис и документы на ввоз. Учитывайте, что Huawei находится под санкциями США, и это может повлиять на сервис, обновления и логистику.
Нативной CUDA нет. Работа идёт через стек Huawei CANN, который поддерживает PyTorch и другие фреймворки. В публикациях говорится о режиме совместимости с CUDA в CANN Next и о гибридной модели программирования SIMD+SIMT. Зрелость экосистемы остаётся главным риском. Китайские компании по-прежнему часто выбирают Nvidia из-за CUDA и отработанного софта. Код, как правило, придётся адаптировать и тестировать.
Huawei заявляет, что по FP4 чип примерно в 2,8 раза быстрее H20, а по FP8 вдвое превосходит H200. Это заявления производителя, и независимые данные пока ограничены. Пропускная способность памяти у 950PR заметно ниже, чем у H20 (около 1,4 ТБ/с против 4 ТБ/с), поэтому в задачах, зависящих от памяти, выигрыш будет меньше. Энергопотребление при этом выше. Реальный результат зависит от модели и программного стека.
Для ускорителя Atlas 350 чаще всего указывают TDP около 600 Вт. Некоторые агрегаторы приводят 900 Вт. Это примерно на 200 Вт больше, чем у Nvidia H20, поэтому нужно заранее посчитать питание и теплоотвод стойки. Официальные данные для вашей конфигурации запрашивайте у поставщика.
Ascend 950PR ориентирован на этап prefill (обработку входного контекста) в инференсе больших языковых моделей и на высокопроизводительные рекомендательные системы. Для этапов decode и обучения Huawei предлагает дополнять его чипом Ascend 950DT. Для полноценного обучения больших моделей одного 950PR недостаточно. Его стоит рассматривать как инференс-узел.
Источники расходятся по цифрам. Для самого чипа указывают до 128 ГБ памяти HiBL 1.0 и до 1,6 ТБ/с. Для ускорителя Atlas 350 называют 112 ГБ и 1,4 ТБ/с. Заявлено до 1,56 PFLOPS в FP4 и около 1 PFLOPS в FP8. Поддерживаются FP8/FP4, а также MXFP8, HiF8, MXFP4 и HiF4. Межчиповое соединение даёт до 2 ТБ/с. Перед закупкой уточните у поставщика точную модификацию и паспорт изделия.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования