Модуль ускорения ИИ Qualcomm Cloud AI100 Ultra 128 ГБ
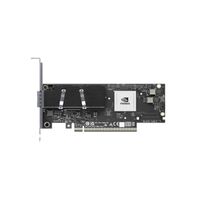
Модуль ускорения ИИ Qualcomm Cloud AI100 Ultra — это PCIe-карта для инференса: она запускает уже обученные нейросети, включая большие языковые модели, компьютерное зрение и обработку текста. Подходит вузам, образовательным центрам и интеграторам, которые строят локальный ИИ-сервер, а не арендуют облако. По данным Qualcomm, карта рассчитана на 150 Вт, несёт 128 ГБ памяти и 64 ИИ-ядра, а значит, тяжёлые модели помещаются в одну карту.
128 ГБ памяти позволяют держать большую модель на одной карте
Объём памяти на карте решает, какую языковую модель удастся запустить без дробления на несколько устройств. У Cloud AI 100 Ultra по данным Qualcomm 128 ГБ памяти LPDDR4x с ECC и 576 МБ встроенной SRAM.
Память с ECC исправляет одиночные сбои, поэтому сервер стабильнее работает круглосуточно. Qualcomm заявляет, что на одной карте можно развернуть модели порядка 100 млрд параметров, на двух картах — порядка 175 млрд. Для сравнения: потребительская видеокарта обычно упирается в память раньше, чем в вычисления.
Пиковая производительность до 870 TOPS при 150 Вт
Карта выдаёт до 870 TOPS в INT8 и до 288 TFLOPS в FP16 при заявленном TDP 150 Вт. Это уровень обычного серверного питания: специальная система охлаждения и отдельная подстанция не нужны, хватит корректно подобранного сервера.
Цифры пиковые, реальная скорость зависит от модели, квантизации и оптимизации. Формат INT8 экономит память и ускоряет расчёты ценой небольшой потери точности, а FP16 сохраняет больше точности.
Сценарии применения в образовании и интеграции
Карта подходит под два типичных проекта: локальный ИИ-ассистент для университета и аналитика видео или голоса в интерактивных классах.
- Университет или школьная сеть разворачивает собственный чат-бот на открытой модели вроде LLaMA. Данные учащихся остаются внутри периметра и не уходят во внешнее облако.
- Интегратор VR/AR/MR-решений обрабатывает на сервере распознавание речи, перевод и компьютерное зрение для иммерсивных классов. Шлемы остаются лёгкими, а вычисления идут на карте.
- Исследовательская лаборатория проверяет гипотезы на моделях разного размера. Несколько пользователей могут работать с картой одновременно.
Программный стек: Cloud AI SDK и форм-фактор PCIe
Карту подключают к хосту через PCIe Gen4 по 16 линиям, а модели адаптируют с помощью Qualcomm Cloud AI SDK. Он оптимизирует обученные модели под ускоритель и работает на хостах x86-64 и ARM64.
Размер платы — 111,2 × 237,9 мм (формат FH3/4L). Перед покупкой проверьте, что в корпусе сервера есть слот нужной длины и линии PCIe. Пропускная способность памяти — 548 ГБ/с. Для генерации текста этот показатель важен не меньше, чем TOPS.
Ограничения: это инференс, а не обучение
Карта создана для запуска готовых моделей, а не для обучения с нуля. Экосистема у неё уже, чем у NVIDIA CUDA: часть моделей придётся компилировать и настраивать через SDK, а готовых примеров меньше.
Планируйте время на портирование и проверьте поддержку нужной модели до закупки. Зато для постоянной нагрузки по инференсу карта выигрывает энергоэффективностью: 150 Вт против заметно более прожорливых серверных GPU.
На что смотреть при выборе
- Размер модели и объём памяти: хватит ли 128 ГБ с запасом под контекст.
- Совместимость сервера: слот PCIe Gen4 x16, питание и охлаждение.
- Поддержка нужной архитектуры модели в SDK.
- Число карт: для больших моделей их можно масштабировать в одном сервере.
| модель | Форм-фактор | Мощность (TDP) | Макс. производительность (INT8) | Пиковые операции (FP16) | SRAM | DRAM (с ECC) | Драма Ч/Б | Интерфейс хоста |
|---|---|---|---|---|---|---|---|---|
| ИИ 100 Ультра | PCIe FH3/4L (111,2 мм x 237,9 мм) | 150 Вт | До 870 ТОП | До 288 терафлопс | 576 МБ | 128 ГБ LPR4x | 548 ГБ/с | PCIe Gen4, 16 линий |
| ИИ 80 Ультра | PCIe FH3/4L (111,2 мм x 237,9 мм) | 150 Вт | До 618 TOPS (155 TOPS/SoC) | До 222 ТФЛОПС (56 ТФЛОПС/SoC) | 576 МБ | 128 ГБ LPR4x | 548 ГБ/с | PCIe Gen4, 16 линий |
| AI 100 Pro | PCIe HHHL (68,9 мм x 169,5 мм) | 75 Вт | До 400 ТОП | До 200 терафлопс | 144 МБ | 32 ГБ LPR4x | 137 ГБ/с | PCIe Gen4, 8 линий |
| Стандарт ИИ 100 | PCIe HHHL (68,9 мм x 169,5 мм) | 75 Вт | До 350 ТОП | До 175 терафлопс | 126 МБ | 16 ГБ LPR4x | 137 ГБ/с | PCIe Gen4, 8 линий |
| Стандарт ИИ 80 | PCIe HHHL (68,9 мм x 169,5 мм) | 75 Вт | До 190 ТОП | До 86 терафлопс | 126 МБ | 16 ГБ LPR4x | 137 ГБ/с | PCIe Gen4, 8 линий |
Для объединения ускорителей внутри стойки (scale-up) используются UALink и ESUN (Ethernet for Scale-Up Networking). Для объединения стоек (scale-out) используются медные и оптические соединения. Полных данных по программному стеку и совместимости с популярными фреймворками для AI300 пока нет. Перед закупкой запросите у вендора подтверждение поддержки нужных вам моделей и инструментов.
Платформа выпускается в вариантах с воздушным и прямым жидкостным охлаждением (DLC), в формате карты и стойки. Предыдущая стойка AI200 рассчитана на 140 кВт и жидкостное охлаждение. Если вы рассматриваете AI300, проверьте мощность электропитания, возможность жидкостного охлаждения и подготовку серверной. Точные данные по потребляемой мощности AI300 Qualcomm пока не опубликовала.
Qualcomm обещает в 4–8 раз лучшую производительность на ватт по сравнению с существующими GPU-решениями. Метрика здесь — пропускная способность памяти на ватт на одну карту. Это не общий показатель скорости во всех задачах. Реальные результаты на ваших моделях можно будет проверить только после выхода образцов, поэтому в расчёты окупаемости пока стоит закладывать запас.
Платформа рассчитана на инференс больших языковых и мультимодальных моделей (LLM, LMM) и агентных ИИ-сценариев. Особенно она подходит для длинного контекста и разделённого (disaggregated) инференса. Для образовательных проектов она подойдёт, если нужен собственный сервер с ИИ-ассистентами для многих пользователей одновременно. Для небольших классов или лабораторий такая платформа избыточна.
Главное отличие — память. AI300 использует технологию HBC Gen 2: вычисления и память объединены в одном корпусе. Qualcomm заявляет рост эффективной пропускной способности памяти на карту в 54 раза относительно AI200, который работает на LPDDR5X. У AI250 с HBC Gen 1 заявлен рост в 18 раз. Это цели производителя. Независимых тестов пока нет.
Это не универсальный CPU и не игровая видеокарта. AI300 — ускоритель инференса, то есть работы уже обученных ИИ-моделей. Он выпускается в формате карты и стойки. В линейке Dragonfly есть и отдельный серверный CPU C1000 с более чем 250 ядрами, но в платформе AI300 они работают как разные компоненты. Для обучения моделей с нуля устройство позиционируется менее явно, чем для инференса.
Прямо сейчас купить его нельзя. Qualcomm анонсировала Dragonfly AI300 в июне 2026 года. Коммерческие образцы (sampling) и поставки ожидаются в 2028 году. Отзывов реальных пользователей и розничных предложений пока нет, а цена не объявлена. Сейчас можно оставить предварительный запрос на подбор решения. Для проектов, которые стартуют раньше, ближайшие доступные продукты линейки — AI200 и AI250.
Остались вопросы?
Наши специалисты с радостью вам ответят и помогут в выборе подходящих для вас решений, продуктов и оборудования